陈云霁,男,1983年生,江西南昌人,研究员,博士生导师。现任中国科学院计算技术研究所副所长、处理器芯片全国重点实验室主任。他还是全国青联常委以及中国青年科协副会长。他长期从事处理器芯片和机器学习的交叉研究,出版教材3部,发表学术论文100余篇。他作为第一完成人获国家自然科学二等奖和中国科学院杰出成就奖,并获国家杰出青年科学基金、全国五一劳动奖章、中国青年五四奖章、何梁何利科技创新奖。他曾被《麻省理工技术评论》评为全球35位杰出青年创新者之一(2015年)。
研究方向是计算机体系结构和机器学习。率领其团队研制了国际上首个深度学习专用处理器芯片,其研究成果已经大规模应用在智能手机和服务器中。学术论文多次获得计算机体系结构顶级国际会议最佳论文奖,
他带领智能处理器研究中心,研制了国际上首个深度学习专用处理器芯片。相关技术广泛应用于多种手机和服务器产品中。他在ISCA、HPCA、ASPLOS、MICRO、ICSE、ISSCC、Hot Chips、IJCAI、IEEE TC、IEEE TPDS、IEEE TCAD、ACM TOCS和CACM等学术会议及期刊上发表论文130余篇,申请专利100余项,获得了ASPLOS和MICRO等计算机体系结构顶级国际会议最佳论文奖(亚洲迄今仅有的两次)。包括哈佛、斯坦福、麻省理工、谷歌等上百个国际知名机构跟踪引用他的学术论文开展深度学习处理器研究。因此,他被Science杂志评价为该方向的“先驱”和“领导者”。
教育及工作经历:
2025-11--中国科学院工业人工智能研究所 副所长
2024-01--2024-07 中国科学院科技基础能力局 副局长
2022-05--处理器芯片全国重点实验室 主任
2021-02--中国科学院计算技术研究所 副所长
2007-07--中国科学院计算技术研究所 助研、副研、研究员
2002-09--2007-07 中国科学院计算技术研究所 博士生
1997-09--2002-07 中国科学技术大学 本科生
认定成果:
1 易编程的异构并行处理器结构 陈云霁;钱诚 中国科学院计算技术研究所 2019
2 非精确加速器结构与编程的若干关键技术的研究 Olivier Temam;陈云霁 中国科学院计算技术研究所 2018
3 超并行高效能计算机体系结构与设计方法研究 李国杰;孙凝辉;胡伟武;范东睿;谭光明;包云岗;陈云霁;冯晓兵;李晓维;韩银和 中国科学院计算技术研究所 2018
4 脑功能联结图谱与类脑智能研究 孙衍刚;蒋毅;陈云霁;蒋田仔;周嘉伟;张旭;杜久林;仇子龙 中国科学院神经科学研究所 2017
5 非精确计算的加速器结构与编程方法研究 陈云霁;吴承勇;陈天石;Olivier Temam 中国科学院计算技术研究所 2016
6 可扩展、可重构片上并行体系结构与原型芯片设计 李国杰;胡伟武;王剑;章隆兵;范东睿;安虹;陈云霁;高翔;唐丹;沈海华;肖俊华 中国科学院计算技术研究所 2010
7 四核龙芯3号处理器设计 胡伟武;王剑;章隆兵;高翔;陈云霁;范宝峡;钟石强;沈海华;齐子初;肖俊华 中国科学院计算技术研究所 2010
8 高性能多核CPU结构设计及原型系统研究 胡伟武;王剑;章隆兵;高翔;陈云霁;钟石强;范宝峡;杨旭;齐子初;沈海华 中国科学院计算技术研究所 2007
发明公开:
[1]贾宏昊, 赵永威, 陈云霁. 大语言模型键-值缓存的量化方法、计算内核[P]. 北京市: CN122886692A, 2026-10-09.
[2]陈惠来, 陈云霁, 文渊博, 李梁锋, 彭少辉, 朱靖哲, 毕钧, 郭崎, 李玲. 一种基于大模型的操作系统内核配置语义感知优化方法及系统[P]. 北京市: CN122777186A, 2026-09-18.
[3]陈云霁, 陈惠来, 文渊博, 李梁锋, 彭少辉, 朱靖哲, 毕钧, 郭崎, 李玲. 一种基于大模型的操作系统内核配置优化方法及系统[P]. 北京市: CN122756786A, 2026-09-15.
[4]张蕊, 张炀, 郭家明, 黄磊, 承书尧, 杜子东, 郭崎, 陈云霁. 一种基于信号感知学习的Verilog代码生成方法及装置[P]. 北京市: CN122756657A, 2026-09-15.
[5]郭家明, 王宏光, 张蕊, 李泽润, 杜子东, 郭崎, 陈云霁. 基于验证驱动端口级迭代分解的Verilog代码生成方法[P]. 北京市: CN122756658A, 2026-09-15.
[6]张蕊, 黄磊, 郭家明, 张炀, 承书尧, 杜子东, 陈云霁, 郭崎. 基于原子逻辑块对齐电路语义的硬件描述代码生成方法[P]. 北京市: CN122674600A, 2026-09-01.
[7]张蕊, 王麒丞, 承书尧, 杜子东, 郭崎, 陈云霁. 一种面向逻辑回归的迭代式函数感知采样方法及系统[P]. 北京市: CN122635223A, 2026-08-25.
[8]张蕊, 王麒丞, 承书尧, 杜子东, 郭崎, 陈云霁. 一种面向自动流水线设计的电路流水级划分方法及系统[P]. 北京市: CN122547414A, 2026-08-11.
[9]郭家明, 李泽润, 张蕊, 王宏光, 承书尧, 杜子东, 郭崎, 陈云霁. 基于HLS设计空间分层探索的硬件描述语言生成方法及装置[P]. 北京市: CN122411952A, 2026-07-17.
[10]李威, 沈新宇, 陈云霁, 郭崎. 面向大模型的分布式异构芯粒强化学习路由优化方法及装置[P]. 北京市: CN121792427A, 2026-04-03.
[11]郭崎, 马天云, 承书尧, 张蕊, 胡杏, 杜子东, 陈云霁. 时序驱动的芯片设计跨阶段加速系统及方法[P]. 北京市: CN121723948A, 2026-03-24.
[12]郭崎, 马天云, 承书尧, 张蕊, 胡杏, 杜子东, 陈云霁. 数字电路关键路径的静态时序分析方法以及装置[P]. 北京市: CN121723949A, 2026-03-24.
[13]承书尧, 张蕊, 贺文凯, 靳鹏威, 李崇骁, 杜子东, 胡杏, 郝一帆, 许广林, 文渊博, 李玲, 郭崎, 陈云霁. 基于学习数据依赖关系的自动化超标量处理器设计方法[P]. 北京市: CN121706677A, 2026-03-20.
[14]赵永威, 郑子夫, 郝一帆, 刘洋, 孔维浩, 陆韵歧, 杜子东, 胡杏, 郭崎, 陈云霁. 一种用于异构集成系统的掩模版复用方法及芯片架构[P]. 北京市: CN121615588A, 2026-03-06.
[15]黄迪, 靳鹏威, 承书尧, 张蕊, 文渊博, 杜子东, 李威, 郭崎, 胡杏, 陈云霁. 基于大语言模型的浮点运算单元Verilog代码生成方法及装置[P]. 北京市: CN121560288A, 2026-02-24.
[16]赵永威, 刘洋, 郝一帆, 蒋东辰, 马志宏, 刘孜晟, 杜子东, 胡杏, 郭崎, 陈云霁. 基于金属互连拓扑编码权重的神经网络处理器系统及方法[P]. 北京市: CN121525759A, 2026-02-13.
[17]赵永威, 陈亦, 刘洋, 郝一帆, 夏瑞阳, 李张劢, 万兆勇, 杜子东, 胡杏, 郭崎, 陈云霁. 一种在处理器阵列上并行处理神经网络模型的方法及系统[P]. 北京市: CN121525760A, 2026-02-13.
[18]支天, 郝一帆, 赵若琪, 杨月仪, 汪原哲, 郭崎, 杜子东, 陈云霁. 神经网络模型中最优量化位宽的测量方法及系统[P]. 北京市: CN121456492A, 2026-02-03.
[19]支天, 郝一帆, 杨月仪, 赵若琪, 马志宏, 郭崎, 杜子东, 陈云霁. 模型迁移的准确度损失测量方法及系统[P]. 北京市: CN121456493A, 2026-02-03.
[20]靳鹏威, 李崇骁, 黄迪, 韩虎生, 承书尧, 赵永威, 张蕊, 杜子东, 郭崎, 胡杏, 陈云霁. 基于对比代码规则库的自动化电路PPA优化方法及装置[P]. 北京市: CN121457413A, 2026-02-03.
[21]郭家明, 张蕊, 李泽润, 胡杏, 杜子东, 张曦珊, 郭崎, 陈云霁, 黄迪. 基于时序扩散模型的机器人轨迹规划方法及装置[P]. 北京市: CN121267890A, 2026-01-06.
[22]黄迪, 李崇骁, 赵阳, 靳鹏威, 南子渊, 高鸣驹, 张蕊, 张曦珊, 杜子东, 郭崎, 胡杏, 陈云霁. 基于多层次摘要的大语言模型硬件描述生成方法及装置[P]. 北京市: CN121209878A, 2025-12-26.
[23]蒋东辰, 郝一帆, 赵永威, 陈云霁. 一种面向智能处理器的解决排序问题的电路自动生成方法[P]. 江苏省: CN121168354A, 2025-12-19.
[24]丁保增, 文渊博, 李威, 郭崎, 陈云霁. 一种基于MLIR的深度学习编译器故障定位方法及装置[P]. 北京市: CN121116674A, 2025-12-12.
[25]张志龙, 吕宗庭, 杨嘉琛, 陈云霁, 肖帅. 一种基于卷积核的矩阵乘法实现方法及装置[P]. 天津市: CN120744266A, 2025-10-03.
[26]张志龙, 吕宗庭, 杨嘉琛, 陈云霁, 肖帅. 一种基于智能处理器的FFT计算方法及装置[P]. 天津市: CN120744290A, 2025-10-03.
[27]郭崎, 文渊博, 余悉越, 毕钧, 陈云霁. 一种神经网络算子加速方法、装置和图形处理器[P]. 北京市: CN120725075A, 2025-09-30.
[28]郭崎, 文渊博, 许健行, 陈云霁. 深度学习编译器中的指令级并行调度方法及装置[P]. 北京市: CN120704740A, 2025-09-26.
[29]陈云霁, 文渊博, 许健行, 郭崎. 一种深度学习编译过程中的任务分解方法及装置[P]. 北京市: CN120687204A, 2025-09-23.
[30]陈云霁, 李威, 黄志浩, 郭崎. 一种无死锁芯粒路由架构构建方法、装置与处理器[P]. 北京市: CN120658672A, 2025-09-16.
[31]胡杏, 韩虎生, 郑昕瑶, 郝一帆, 宋新开, 杜子东, 郭崎, 陈云霁. 一种异构可信执行环境架构构建方法、装置及处理器[P]. 北京市: CN120611378A, 2025-09-09.
[32]陈云霁, 郝一帆, 周恩帅, 张蕊, 郭雨轩. 一种基于涌现通信的数量概念泛化方法及系统[P]. 北京市: CN120375371A, 2025-07-25.
[33]黄迪, 吴钰同, 史文轩, 南子渊, 袁凯钊, 张蕊, 张曦珊, 杜子东, 郭崎, 胡杏, 陈云霁. 一种基于指令微调的大语言模型训练数据生成方法及其系统[P]. 北京市: CN120046659A, 2025-05-27.
[34]陈云霁, 郝一帆, 李张劢, 赵永威, 杜子东, 郭崎, 夏瑞阳, 支天, 李威. 基于拓扑计算的大模型推理计算架构、方法及装置[P]. 北京市: CN119740663A, 2025-04-01.
[35]陈云霁, 郝一帆, 陆韵岐, 赵永威, 杜子东, 郭崎, 孔维浩, 支天, 李威. 大模型推理芯片的验证方法、装置、存储介质[P]. 北京市: CN119623377A, 2025-03-14.
[36]郝一帆, 马志宏, 蒋东辰, 赵永威, 郭崎, 杜子东, 陈云霁. 基于大语言模型的旋转位置编码的编码方法及装置[P]. 北京市: CN119622156A, 2025-03-14.
[37]郭崎, 郝一帆, 郑子夫, 赵永威, 杜子东, 陈云霁, 刘洋, 支天, 李威. 一种基于权值拓扑连接的大模型计算装置及其方法[P]. 北京市: CN119623543A, 2025-03-14.
[38]郭崎, 董守杨, 文渊博, 陈云霁. 一种跨平台程序转译方法及装置[P]. 北京市: CN119166163A, 2024-12-20.
[39]李威, 黄志浩, 陈惠来, 陈云霁, 郭崎. 一种基于芯粒结构编码的芯片性能预测方法及装置[P]. 北京市: CN118504517A, 2024-08-16.
[40]陈云霁, 刘洋, 赵永威, 杜子东, 郭崎. 串行压缩单元、深度神经网络加速器[P]. 北京市: CN118468966A, 2024-08-09.
[41]陈云霁, 孔维浩, 郝一帆, 郭崎, 赵永威, 杜子东, 宋新开, 邹沫, 李夏青. 扩散模型加速器及其全网络差分数据流计算方法[P]. 北京市: CN118446267A, 2024-08-06.
[42]丁保增, 李威, 郭崎, 陈云霁. 基于AI处理器板卡任务调度的AI任务执行加速方法及装置[P]. 北京市: CN118394482A, 2024-07-26.
[43]陈云霁, 承书尧, 靳鹏威, 郭崎, 杜子东, 张蕊, 田韵豪, 胡杏, 赵永威, 郝一帆, 关翔涛, 韩虎生, 赵政越, 刘晰鸣, 张曦珊, 褚越杰, 毛卫龙, 陈天石. 基于近似电路生成的逻辑电路自动生成方法及系统[P]. 北京市: CN118313322A, 2024-07-09.
[44]毕钧, 文渊博, 郭崎, 陈云霁, 郝一帆, 杜子东. 算子库生成方法、装置[P]. 北京市: CN118259889A, 2024-06-28.
[45]张蕊, 郭家明, 彭少辉, 易琦, 胡杏, 杜子东, 张曦珊, 郭崎, 陈云霁. 基于上下文符号策略的元强化学习自动控制方法及系统[P]. 北京市: CN117991628A, 2024-05-07.
[46]郝一帆, 郭雨轩, 张蕊, 周恩帅, 陈云霁. 基于涌现交流规则的多智能体通信方法及系统[P]. 北京市: CN117746844A, 2024-03-22.
[47]张蕊, 易琦, 彭少辉, 郭家明, 胡杏, 杜子东, 郭崎, 陈云霁. 一种捕捉环境中可控因素的表示学习方法及系统[P]. 北京市: CN117688983A, 2024-03-12.
[48]张蕊, 易琦, 彭少辉, 郭家明, 胡杏, 杜子东, 张曦珊, 郭崎, 陈云霁. 一种基于对象的强化学习方法及系统[P]. 北京市: CN117689912A, 2024-03-12.
[49]胡杏, 党朴成, 韩虎生, 黄迪, 张蕊, 杜子东, 郭崎, 陈云霁. 破除图像数据不可学习噪声的深度学习训练方法及系统[P]. 北京市: CN117475254A, 2024-01-30.
[50]陈云霁, 陈小兵, 刘少礼, 陈天石. 用于执行LSTM神经网络运算的装置和运算方法[P]. 上海市: CN113537480A, 2021-10-22.
[51]陈云霁, 陈小兵, 刘少礼, 陈天石. 用于执行LSTM神经网络运算的装置和运算方法[P]. 上海市: CN113537481A, 2021-10-22.
[52]韩栋, 郭崎, 陈天石, 陈云霁. 一种神经网络maxout层计算装置[P]. 北京市: CN112348182A, 2021-02-09.
[53]李震, 刘少礼, 陈天石, 陈云霁. 浮点数处理器[P]. 北京市: CN112230881A, 2021-01-15.
[54]陈云霁, 刘少礼, 陈天石. 一种运算装置及其操作方法[P]. 北京市: CN112214244A, 2021-01-12.
[55]刘少礼, 宋琎, 陈云霁, 陈天石. 一种用于执行人工神经网络pooling运算的装置和方法[P]. 北京市: CN111860772A, 2020-10-30.
[56]刘少礼, 兰慧盈, 郭崎, 陈云霁, 陈天石. 一种用于执行人工神经网络全连接层正向运算的装置和方法[P]. 北京市: CN111860811A, 2020-10-30.
[57]陈云霁, 支天, 刘少礼, 郭崎, 陈天石. 一种用于执行卷积神经网络训练的装置和方法[P]. 北京市: CN111860812A, 2020-10-30.
[58]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种用于执行卷积神经网络正向运算的装置和方法[P]. 北京市: CN111860813A, 2020-10-30.
[59]刘少礼, 于涌, 陈云霁, 陈天石. 一种用于执行batch normalization运算的装置和方法[P]. 北京市: CN111860814A, 2020-10-30.
[60]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵加/减运算的装置和方法[P]. 北京市: CN111857819A, 2020-10-30.
[61]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵加/减运算的装置和方法[P]. 北京市: CN111857820A, 2020-10-30.
[62]刘道福, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于生成服从一定分布的随机向量装置和方法[P]. 北京市: CN111857821A, 2020-10-30.
[63]陈云霁, 刘少礼, 陈天石. 一种运算装置及其操作方法[P]. 北京市: CN111857822A, 2020-10-30.
[64]赵永威, 支天, 杜子东, 陈云霁, 徐志伟, 孙凝晖, 郭崎. 用于分形智能处理器的控制系统、方法及电子设备[P]. 北京市: CN111857824A, 2020-10-30.
[65]赵永威, 支天, 杜子东, 陈云霁, 徐志伟, 孙凝晖, 郭崎. 并行计算智能处理器及并行计算智能处理方法[P]. 北京市: CN111857833A, 2020-10-30.
[66]赵永威, 支天, 杜子东, 陈云霁, 徐志伟, 孙凝晖, 郭崎. 用于智能处理器的控制系统、方法及电子设备[P]. 北京市: CN111831332A, 2020-10-27.
[67]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量逻辑运算的装置[P]. 北京市: CN111651202A, 2020-09-11.
[68]支天, 刘少礼, 郭崎, 陈天石, 陈云霁. 一种用于执行向量最大值最小值运算的装置和方法[P]. 北京市: CN111651204A, 2020-09-11.
[69]陶劲桦, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量四则运算的装置和方法[P]. 北京市: CN111651203A, 2020-09-11.
[70]支天, 郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量内积运算的装置和方法[P]. 北京市: CN111651205A, 2020-09-11.
[71]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量外积运算的装置和方法[P]. 北京市: CN111651206A, 2020-09-11.
[72]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580864A, 2020-08-25.
[73]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580866A, 2020-08-25.
[74]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580865A, 2020-08-25.
[75]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580863A, 2020-08-25.
[76]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络反向训练的装置和方法[P]. 北京市: CN111353588A, 2020-06-30.
[77]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN111353589A, 2020-06-30.
[78]陈云霁, 支天, 刘少礼, 郭崎, 陈天石. 一种用于执行卷积神经网络训练的装置和方法[P]. 北京市: CN111310904A, 2020-06-19.
[79]韩栋, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量比较运算的装置和方法[P]. 北京市: CN111176608A, 2020-05-19.
[80]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵乘运算的装置和方法[P]. 北京市: CN111104164A, 2020-05-05.
[81]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵乘运算的装置和方法[P]. 北京市: CN111090467A, 2020-05-01.
[82]郭崎, 陈峋宇, 陈云霁, 陈天石. 用于执行LSTM运算的装置和方法[P]. 北京市: CN110929863A, 2020-03-27.
[83]陈天石, 刘少礼, 陈云霁. 神经网络运算装置及方法[P]. 北京市: CN110298443A, 2019-10-01.
[84]李震, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络自学习运算的装置和方法[P]. 北京市: CN110188870A, 2019-08-30.
[85]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络反向运算的装置和方法[P]. 北京市: CN110135581A, 2019-08-16.
[86]张磊, 杜子东, 陈云霁. 脉冲神经网络转换方法及相关转换芯片[P]. 北京市: CN110059800A, 2019-07-26.
[87]张磊, 杜子东, 陈云霁. 脉冲神经网络运算芯片及相关运算方法[P]. 北京市: CN110059812A, 2019-07-26.
[88]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109993285A, 2019-07-09.
[89]陈云霁, 刘少礼, 郭崎, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109934331A, 2019-06-25.
[90]陈天石, 刘少礼, 郭崎, 陈云霁. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109858623A, 2019-06-07.
[91]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109726168A, 2019-05-07.
[92]周诗怡, 陈云霁. 智能摄像头及控制系统[P]. 北京市: CN109714526A, 2019-05-03.
[93]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109710558A, 2019-05-03.
[94]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109710559A, 2019-05-03.
[95]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109697184A, 2019-04-30.
[96]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109684267A, 2019-04-26.
[97]周诗怡, 陈云霁. 视频智能生成方法及装置[P]. 北京市: CN109658369A, 2019-04-19.
[98]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109656867A, 2019-04-19.
[99]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109634904A, 2019-04-16.
[100]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109634905A, 2019-04-16.
[101]刘少礼, 兰慧盈, 郭崎, 陈云霁, 陈天石. 一种用于执行全连接层神经网络正向运算的装置和方法[P]. 北京市: CN109375951A, 2019-02-22.
[102]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109376112A, 2019-02-22.
[103]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109376113A, 2019-02-22.
[104]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109376114A, 2019-02-22.
[105]郭崎, 张士锦, 陈云霁, 陈天石. 一种用于执行全连接层神经网络训练的装置和方法[P]. 北京市: CN109376861A, 2019-02-22.
[106]刘少礼, 于涌, 陈云霁, 陈天石. 支持离散数据表示的人工神经网络正向运算装置和方法[P]. 北京市: CN109358900A, 2019-02-19.
[107]郭崎, 陈峋宇, 陈云霁, 陈天石. 用于执行LSTM运算的装置和方法[P]. 北京市: CN109284825A, 2019-01-29.
[108]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵乘运算的装置和方法[P]. 北京市: CN109240746A, 2019-01-18.
[109]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109242094A, 2019-01-18.
[110]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种用于执行卷积神经网络正向运算的装置和方法[P]. 北京市: CN109086877A, 2018-12-25.
[111]高钰峰, 陈云霁. 一种利用人工智能芯片处理图像视频帧的方法[P]. 北京市: CN108921012A, 2018-11-30.
[112]钱诚, 莫焕生, 陈云霁. 数据处理方法及装置[P]. 广东: CN108874728A, 2018-11-23.
[113]张潇, 金禄旸, 张磊, 陈云霁. 基于小波变换压缩和/或解压缩的神经网络处理方法[P]. 北京: CN108764454A, 2018-11-06.
[114]吴凡迪, 陈云霁. 一种进行神经网络运算的处理装置[P]. 北京: CN108764465A, 2018-11-06.
[115]高钰峰, 陈云霁. 用于智能识别的人工神经网络处理器[P]. 北京: CN108764468A, 2018-11-06.
[116]吴凡迪, 陈云霁. 一种人工神经网络运算的处理方法[P]. 北京: CN108764470A, 2018-11-06.
[117]高钰峰, 陈云霁. 基于人工神经网络处理器的云端协同智能芯片[P]. 北京: CN108675071A, 2018-10-19.
[118]张磊, 金禄旸, 张潇, 陈云霁. 一种基于小波变换减少IO开销的神经网络处理系统[P]. 北京: CN108665062A, 2018-10-16.
[119]高钰峰, 陈云霁. 基于LSTM网络模型的处理芯片与包含其的运算装置[P]. 北京: CN108639882A, 2018-10-12.
[120]高钰峰, 陈云霁. 一种使用神经网络芯片处理图像的方法[P]. 北京: CN108647660A, 2018-10-12.
[121]吴凡迪, 陈云霁. 一种人工智能芯片处理装置[P]. 北京: CN108647781A, 2018-10-12.
[122]张磊, 金禄旸, 张潇, 陈云霁. 一种基于主成分分析减少IO开销的神经网络处理系统[P]. 北京: CN108629409A, 2018-10-09.
[123]张潇, 金禄旸, 张磊, 陈云霁. 基于主成分分析降维和/或升维的神经网络处理方法[P]. 北京: CN108629410A, 2018-10-09.
[124]金禄旸, 张潇, 张磊, 陈云霁. 基于压缩感知的神经网络处理系统及方法[P]. 北京: CN108615074A, 2018-10-02.
[125]张团, 陈云霁. 一种用于执行Faster R-CNN神经网络运算的方法和装置[P]. 北京: CN108597582A, 2018-09-28.
[126]韩栋, 刘少礼, 陈云霁, 陈天石. 用于向量运算的数据读取、写入及读写调度器及保留站[P]. 北京: CN108595371A, 2018-09-28.
[127]高钰峰, 陈云霁. 用于对视频帧进行神经网络运算的图像处理装置[P]. 北京: CN108566537A, 2018-09-21.
[128]高钰峰, 陈云霁. 基于神经网络的信息处理装置及方法[P]. 北京: CN108545556A, 2018-09-18.
[129]张团, 陈云霁. 一种利用Volume R-CNN神经网络进行运算的方法和装置[P]. 北京: CN108537329A, 2018-09-14.
[130]张士锦, 罗韬, 刘少礼, 陈云霁. 一种用于自动校正访问存储装置数据的装置及方法[P]. 北京: CN108511027A, 2018-09-07.
[131]张士锦, 罗韬, 刘少礼, 陈云霁. 利用纠错码自动校正访问存储装置数据的装置及方法[P]. 北京: CN108511028A, 2018-09-07.
[132]杜子东, 郭崎, 陈天石, 陈云霁. 包括多个核心处理模块的人工神经网络的处理系统及方法[P]. 北京: CN108510064A, 2018-09-07.
[133]刘少礼, 张潇, 陈云霁, 陈天石. 子矩阵运算装置及方法[P]. 北京: CN108491359A, 2018-09-04.
[134]陈天石, 刘少礼, 郭崎, 陈云霁. 神经网络计算系统和方法[P]. 北京: CN108427990A, 2018-08-21.
[135]杜子东, 郭崎, 陈天石, 陈云霁. 使用多核心处理模块进行神经网络划分的方法及其系统[P]. 北京: CN108416436A, 2018-08-17.
[136]杜子东, 郭崎, 陈天石, 陈云霁. 用于乘加运算的人工神经网络的处理系统及方法[P]. 北京: CN108416437A, 2018-08-17.
[137]刘少礼, 张潇, 陈云霁, 陈天石. 卷积运算装置及方法[P]. 北京: CN108388541A, 2018-08-10.
[138]于涌, 陈云霁. LSTM神经网络芯片及其使用方法[P]. 北京: CN108388944A, 2018-08-10.
[139]于涌, 陈云霁. 基于N-GRAM和WFST模型的人工神经网络芯片及其应用方法[P]. 北京: CN108364066A, 2018-08-03.
[140]陈云霁, 陈小兵, 刘少礼, 陈天石. 用于执行LSTM神经网络运算的装置和运算方法[P]. 上海: CN108268939A, 2018-07-10.
[141]陈天石, 任逸轩, 郭崎, 杜子东, 支天, 陈云霁. 一种用于非精确计算神经网络的电路设计方法[P]. 上海: CN108256642A, 2018-07-06.
[142]郭崎, 陈小兵, 刘少礼, 陈天石, 陈云霁. 一种基于HMC的神经网络运算装置和方法[P]. 上海: CN108256643A, 2018-07-06.
[143]陈天石, 李韦, 郭崎, 陈云霁. 基于高带宽存储器的神经网络计算装置和方法[P]. 上海: CN108241484A, 2018-07-03.
[144]陈天石, 韦洁, 陈云霁, 刘少礼, 支天, 郭崎. 压缩/解压缩神经网络模型的装置、设备和方法[P]. 上海: CN108229644A, 2018-06-29.
[145]陈云霁, 李尚应, 郭崎, 陈天石. 一种运算多种超越函数的装置[P]. 上海: CN108228135A, 2018-06-29.
[146]陈云霁, 郝一帆, 刘少礼, 陈天石. 人工神经网络反向训练装置和方法[P]. 上海: CN108205706A, 2018-06-26.
[147]陈天石, 郝一帆, 刘少礼, 陈云霁, 李震. 获取函数值的装置、方法及神经网络装置[P]. 上海: CN108205518A, 2018-06-26.
[148]郭崎, 刘少礼, 陈云霁, 其他发明人请求不公开姓名. 矩阵乘加运算装置和方法[P]. 上海: CN108205519A, 2018-06-26.
[149]吴林阳, 郭雪婷, 陈云霁. 哈希分区加速器[P]. 北京: CN108196662A, 2018-06-22.
[150]吴林阳, 郭雪婷, 陈云霁. 哈希混合加速系统及应用其进行哈希连接的方法[P]. 北京: CN108182084A, 2018-06-19.
[151]周聖元, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 神经网络运算装置及应用其进行运算的方法[P]. 北京: CN108170640A, 2018-06-15.
[152]吴林阳, 郭雪婷, 陈云霁. 含哈希分区加速器和内存的组合装置[P]. 北京: CN108170253A, 2018-06-15.
[153]于涌, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 计数方法及装置[P]. 北京: CN108052984A, 2018-05-18.
[154]陈云霁, 庄毅敏, 郭崎, 陈天石. 一种神经网络训练方法及装置[P]. 北京: CN108021981A, 2018-05-11.
[155]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京: CN108021528A, 2018-05-11.
[156]陈天石, 刘少礼, 郭崎, 陈云霁. 一种执行人工神经网络运算的装置和方法[P]. 北京: CN107886166A, 2018-04-06.
[157]陈天石, 刘少礼, 陈云霁. 神经网络运算装置及方法[P]. 北京: CN107886167A, 2018-04-06.
[158]陈天石, 王秉睿, 张潇, 刘少礼, 陈云霁. 运算装置以及相关产品[P]. 上海: CN107861757A, 2018-03-30.
[159]于涌, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 计数方法及装置[P]. 北京: CN107818343A, 2018-03-20.
[160]陈天石, 郭崎, 陈云霁. 一种支持多数据流的TLB装置和TLB模块的更新方法[P]. 北京: CN107783912A, 2018-03-09.
[161]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种卷积神经网络运算指令及其方法[P]. 北京: CN107704267A, 2018-02-16.
[162]陈云霁, 张潇, 刘少礼, 陈天石. 一种矩阵运算指令及其方法[P]. 江苏: CN107704433A, 2018-02-16.
[163]陈云霁, 刘少礼, 陈天石. 一种运算装置及其操作方法[P]. 北京: CN107688466A, 2018-02-13.
[164]陈云霁, 刘少礼, 韩栋, 陈天石. 一种用于执行神经网络运算的装置及方法[P]. 北京: CN107688853A, 2018-02-13.
[165]周聖元, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 可重构的S型运算装置及运算方法[P]. 北京: CN107632965A, 2018-01-26.
[166]张士锦, 郭崎, 陈天石, 陈云霁. 一种用于执行Hessian-Free训练算法的装置和方法[P]. 北京: CN107341540A, 2017-11-10.
[167]郭崎, 张士锦, 陈云霁, 陈天石. 一种用于执行全连接层神经网络训练的装置和方法[P]. 北京: CN107341541A, 2017-11-10.
[168]郭崎, 陈峋宇, 陈云霁, 陈天石. 用于执行循环神经网络和LSTM运算的装置和方法[P]. 北京: CN107341542A, 2017-11-10.
[169]郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行AdaGrad梯度下降训练算法的装置和方法[P]. 北京: CN107341132A, 2017-11-10.
[170]刘少礼, 于涌, 陈云霁, 陈天石. 一种用于执行batch normalization运算的装置和方法[P]. 北京: CN107341546A, 2017-11-10.
[171]陈云霁, 支天, 刘少礼, 郭崎, 陈天石. 一种用于执行卷积神经网络训练的装置和方法[P]. 北京: CN107341547A, 2017-11-10.
[172]陈天石, 刘少礼, 郭崎, 陈云霁. 一种支持较少位数浮点数的神经网络运算的装置和方法[P]. 北京: CN107340993A, 2017-11-10.
[173]陶劲桦, 陈天石, 陈云霁. 一种用于执行神经网络运算以及矩阵/向量运算的装置和方法[P]. 北京: CN107329936A, 2017-11-07.
[174]张士锦, 李尚应, 陈天石, 陈云霁. 一种用于执行多种超越函数运算的装置和方法[P]. 北京: CN107329732A, 2017-11-07.
[175]刘少礼, 宋琎, 陈云霁, 陈天石. 用于执行pooling运算的装置和方法[P]. 北京: CN107329733A, 2017-11-07.
[176]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种用于执行卷积神经网络正向运算的装置和方法[P]. 北京: CN107329734A, 2017-11-07.
[177]陈云霁, 刘少礼, 郭崎, 陈天石. 一种用于执行人工神经网络正向运算的装置和方法[P]. 北京: CN107330515A, 2017-11-07.
[178]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵乘运算的装置和方法[P]. 北京: CN107315574A, 2017-11-03.
[179]李震, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量合并运算的装置和方法[P]. 北京: CN107315575A, 2017-11-03.
[180]李震, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络自学习运算的装置和方法[P]. 北京: CN107316078A, 2017-11-03.
[181]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵加/减运算的装置和方法[P]. 北京: CN107315715A, 2017-11-03.
[182]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量外积运算的装置和方法[P]. 北京: CN107315716A, 2017-11-03.
[183]陶劲桦, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量四则运算的装置和方法[P]. 北京: CN107315717A, 2017-11-03.
[184]支天, 郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量内积运算的装置和方法[P]. 北京: CN107315718A, 2017-11-03.
[185]韩栋, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量比较运算的装置和方法[P]. 北京: CN107315563A, 2017-11-03.
[186]韩栋, 张潇, 陈天石, 陈云霁. 一种用于执行向量超越函数运算的装置和方法[P]. 北京: CN107315564A, 2017-11-03.
[187]刘道福, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于生成服从一定分布的随机向量装置和方法[P]. 北京: CN107315565A, 2017-11-03.
[188]刘道福, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量循环移位运算的装置和方法[P]. 北京: CN107315566A, 2017-11-03.
[189]支天, 刘少礼, 郭崎, 陈天石, 陈云霁. 一种用于执行向量最大值最小值运算的装置和方法[P]. 北京: CN107315567A, 2017-11-03.
[190]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量逻辑运算的装置[P]. 北京: CN107315568A, 2017-11-03.
[191]刘少礼, 郭崎, 陈天石, 陈云霁. 一种用于执行RMSprop梯度下降算法的装置及方法[P]. 北京: CN107315569A, 2017-11-03.
[192]郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行Adam梯度下降训练算法的装置及方法[P]. 北京: CN107315570A, 2017-11-03.
[193]刘少礼, 兰慧盈, 郭崎, 陈云霁, 陈天石. 一种用于执行全连接层神经网络正向运算的装置和方法[P]. 北京: CN107315571A, 2017-11-03.
[194]刘少礼, 张潇, 陈云霁, 陈天石. 一种子矩阵运算装置及方法[P]. 北京: CN107305538A, 2017-10-31.
[195]兰慧盈, 郭崎, 陈云霁, 陈天石, 李尚应. 一种非线性函数运算装置及方法[P]. 北京: CN107305484A, 2017-10-31.
[196]郭崎, 周聖元, 李震, 陈云霁, 陈天石. 一种用于执行多个浮点数相加的装置及方法[P]. 北京: CN107305485A, 2017-10-31.
[197]韩栋, 郭崎, 陈天石, 陈云霁. 一种神经网络maxout层计算装置[P]. 北京: CN107305486A, 2017-10-31.
[198]刘少礼, 于涌, 陈云霁, 陈天石. 支持离散数据表示的人工神经网络正向运算装置和方法[P]. 北京: CN107301453A, 2017-10-27.
[199]郭崎, 于涌, 陈天石, 陈云霁. 支持离散数据表示的人工神经网络反向训练装置和方法[P]. 北京: CN107301454A, 2017-10-27.
[200]杜子东, 郭崎, 陈天石, 陈云霁. 神经网络的计算方法、系统及其装置[P]. 北京: CN107203807A, 2017-09-26.
[201]陈天石, 支天, 罗宇哲, 刘少礼, 郭崎, 陈云霁. 基于深度自动编码器的视频编解码装置及方法[P]. 上海: CN107046646A, 2017-08-15.
[202]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量计算装置[P]. 江苏: CN106990940A, 2017-07-28.
[203]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 江苏: CN106991476A, 2017-07-28.
[204]陈天石, 刘少礼, 郭崎, 陈云霁. 一种人工神经网络压缩编码装置和方法[P]. 江苏: CN106991477A, 2017-07-28.
[205]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络反向训练的装置和方法[P]. 江苏: CN106991478A, 2017-07-28.
[206]韩栋, 刘少礼, 陈云霁, 陈天石. 用于向量运算的数据读写调度器及保留站[P]. 江苏: CN106991073A, 2017-07-28.
[207]陈云霁, 张潇, 刘少礼, 陈天石. 一种矩阵计算装置[P]. 江苏: CN106991077A, 2017-07-28.
[208]李震, 刘少礼, 陈天石, 陈云霁. 一种浮点数处理装置[P]. 江苏: CN106990937A, 2017-07-28.
[209]张士锦, 罗韬, 刘少礼, 陈云霁. 一种用于DRAM或eDRAM刷新的装置及其方法[P]. 北京: CN106856098A, 2017-06-16.
[210]陈云霁, 李韦, 杜子东, 郭崎, 陈天石. 一种流执行方法及装置[P]. 上海: CN106845631A, 2017-06-13.
[211]韦洁, 郭崎, 陈天石, 陈云霁. 一种表情图片推送方法及系统[P]. 上海: CN106599926A, 2017-04-26.
[212]陈云霁, 任逸轩, 杜子东, 陈天石. 一种指令生成过程的复用方法及装置[P]. 上海: CN106557332A, 2017-04-05.
[213]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 加速深度神经网络算法的加速芯片的运算装置及方法[P]. 北京: CN106529668A, 2017-03-22.
[214]陈云霁, 郭崎, 陈天石. 用于预防电信诈骗的装置和方法[P]. 北京: CN106327221A, 2017-01-11.
[215]杜子东, 郭崎, 陈天石, 陈云霁. 一种神经网络的处理方法、系统[P]. 北京: CN105930902A, 2016-09-07.
[216]郭崎, 陈天石, 陈云霁. 片上重复寻址的方法及装置[P]. 北京: CN105912476A, 2016-08-31.
[217]杜子东, 郭崎, 陈天石, 陈云霁. 一种神经网络加速器及其运算方法[P]. 北京: CN105892989A, 2016-08-24.
[218]陈天石, 杜子东, 郭崎, 陈云霁. 片上数据划分读写方法、系统及其装置[P]. 北京: CN105843775A, 2016-08-10.
[219]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 多输入多输出处理器流水线数据同步装置及方法[P]. 北京: CN105824604A, 2016-08-03.
[220]罗韬, 刘少礼, 张士锦, 陈云霁. 分形树中向量数据回传处理单元的装置、方法、控制装置及智能芯片[P]. 北京: CN105630733A, 2016-06-01.
[221]罗韬, 刘少礼, 张士锦, 陈云霁. 基于分形树结构的数据发布装置、方法、控制装置及智能芯片[P]. 北京: CN105634960A, 2016-06-01.
[222]张士锦, 罗韬, 刘少礼, 陈云霁. 一种用于自动校正访问存储装置数据的装置及方法[P]. 北京: CN105609141A, 2016-05-25.
[223]罗韬, 刘少礼, 张士锦, 陈云霁. 一种分形树结构通信结构、方法、控制装置及智能芯片[P]. 北京: CN105550157A, 2016-05-04.
[224]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 数据累加装置、方法及数字信号处理装置[P]. 北京: CN105528191A, 2016-04-27.
[225]张士锦, 郭崎, 陈云霁, 陈天石. 一种用于稀疏连接的人工神经网络计算装置和方法[P]. 江苏: CN105512723A, 2016-04-20.
[226]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 加法器装置、数据累加方法及数据处理装置[P]. 北京: CN105512724A, 2016-04-20.
[227]刘道福, 周圣元, 陈云霁. 硬件实现的数据排序装置、方法及数据处理芯片[P]. 北京: CN105512179A, 2016-04-20.
[228]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 加速深度神经网络算法的加速芯片的运算装置及方法[P]. 北京: CN105488565A, 2016-04-13.
[229]张士锦, 罗韬, 刘少礼, 陈云霁. 一种用于DRAM或eDRAM刷新的装置及其方法[P]. 北京: CN105489240A, 2016-04-13.
[230]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 流水级运算装置、数据处理方法及片上网络芯片[P]. 北京: CN105468335A, 2016-04-06.
[231]刘雨辰, 罗韬, 刘少礼, 张士锦, 陈云霁. 互连电路的数据处理装置和方法[P]. 北京: CN105468546A, 2016-04-06.
[232]张士锦, 罗韬, 刘少礼, 陈云霁. 一种非线性函数的快速运算装置及其方法[P]. 北京: CN105354006A, 2016-02-24.
[233]王亮, 陈云霁. 一种发动机ECC二维码检测系统[P]. 江苏: CN104408487A, 2015-03-11.
[234]王亮, 陈云霁. 汽车零部件视觉检测系统[P]. 江苏: CN104316033A, 2015-01-28.
[235]王亮, 陈云霁. 一种平安乡村智能视频监控方法与系统[P]. 江苏: CN104320625A, 2015-01-28.
[236]李磊, 陈云霁, 尹夕振. 多核处理器及其并行重放方法[P]. 北京: CN103970512A, 2014-08-06.
[237]王佳, 陈云霁, 尹夕振. 面向重放机制的缓存操作方法及装置[P]. 北京: CN103744800A, 2014-04-23.
[238]尹一笑, 陈云霁, 胡伟武. 一种降低动态冗余多线程性能和功耗开销的方法及系统[P]. 北京: CN103699458A, 2014-04-02.
[239]李磊, 陈云霁, 孙国庆. 并行程序的数据竞争检测方法、装置及多核处理系统[P]. 北京: CN103488563A, 2014-01-01.
[240]尹一笑, 陈云霁, 胡伟武. 一种降低处理器软错误率的方法和系统[P]. 北京: CN103365731A, 2013-10-23.
[241]冯晓雪, 陈云霁, 李磊, 李梦竹. 基于确定性重放的并行系统弱一致性的验证方法和系统[P]. 北京: CN103365776A, 2013-10-23.
[242]尹一笑, 陈云霁, 胡伟武. 一种降低多线程程序功耗的方法及系统[P]. 北京: CN103336571A, 2013-10-02.
[243]尹一笑, 陈云霁, 胡伟武. 一种降低多线程程序功耗的方法及系统[P]. 北京: CN103324269A, 2013-09-25.
[244]刘少礼, 陈云霁, 陈天石, 李玲, 孙国庆. 网络拥塞信息传输方法和装置[P]. 北京: CN103312603A, 2013-09-18.
[245]王磊, 陈云霁, 陈天石, 陆超, 李梦竹. 一种异构多核线程调度方法、系统及异构多核处理器[P]. 北京: CN103294550A, 2013-09-11.
[246]刘道福, 陈云霁, 郭崎, 胡伟武. 缓存预测执行的处理器与装置及方法[P]. 北京: CN102841857A, 2012-12-26.
[247]吴瑞阳, 陈云霁, 胡伟武, 杨梁. 指令执行流信息处理系统和装置及方法[P]. 北京: CN102819419A, 2012-12-12.
[248]刘少礼, 李玲, 陈云霁. 一种视频编解码访存优化系统和方法[P]. 北京: CN102769755A, 2012-11-07.
[249]刘道福, 李玲, 钱诚, 陈云霁. 实现H.264的CAVLC的熵解码器和方法[P]. 北京: CN102710937A, 2012-10-03.
[250]尹一笑, 陈云霁, 郭崎, 杨旭. 片上网络多核处理器多线程的资源分配处理方法和系统[P]. 北京: CN102591722A, 2012-07-18.
[251]李磊, 陈云霁, 孙国庆. 一种基于确定性重放的处理器整体故障检测系统与方法[P]. 北京: CN102591763A, 2012-07-18.
[252]王磊, 刘道福, 陈云霁, 郭崎, 张戈. 一种弱一致性存储模型的数据访存系统和方法[P]. 北京: CN102591800A, 2012-07-18.
[253]陈云霁, 陆超, 钟石强. 片上网络路由集中控制系统和装置及自适应路由控制方法[P]. 北京: CN102546406A, 2012-07-04.
[254]李磊, 陈云霁, 苏孟豪. 在处理器中控制不同锁相环输出时钟的控制系统和方法[P]. 北京: CN102394641A, 2012-03-28.
[255]胡伟武, 刘宏伟, 陈云霁. 一种多媒体变换乘法器及其处理方法[P]. 北京: CN102043605A, 2011-05-04.
[256]李向库, 齐子初, 马麟, 李晓钰, 陈云霁, 胡伟武. 一种处理器芯片频率的筛选方法[P]. 北京: CN101839962A, 2010-09-22.
[257]王朋宇, 陈云霁, 沈海华, 胡伟武. 一种微处理器指令级随机验证中加速取指的装置和方法[P]. 北京: CN101819608A, 2010-09-01.
[258]苏孟豪, 陈云霁. 一种多时钟数字系统及其时钟确定装置和方法[P]. 北京: CN101739500A, 2010-06-16.
[259]苏孟豪, 陈云霁. 一种支持处理器硅后调试的装置和方法[P]. 北京: CN101714114A, 2010-05-26.
[260]胡伟武, 吴瑞阳, 钱诚, 陈云霁. 实现多核处理器EJTAG可调试性的装置及系统[P]. 北京: CN101710300A, 2010-05-19.
[261]胡伟武, 陈云霁, 朱海涛. 浮点向量乘加运算装置和方法[P]. 北京: CN101706712A, 2010-05-12.
[262]王玲, 高翔, 陈云霁. 矩阵转置自动控制电路系统及矩阵转置方法[P]. 北京: CN101706760A, 2010-05-12.
[263]陈云霁, 钱诚. 包含四条指令的支持快速傅里叶变换运算的方法[P]. 北京: CN101706770A, 2010-05-12.
[264]钱诚, 陈云霁, 王玲. 一种DMA控制器的控制装置及控制方法[P]. 北京: CN101702144A, 2010-05-05.
[265]陈云霁, 钱诚, 胡伟武. 一种自动纠错系统及方法[P]. 北京: CN101477481, 2009-07-08.
[266]胡伟武, 陈云霁, 钱诚. 一种门控时钟系统及其工作方法[P]. 北京: CN101446842, 2009-06-03.
[267]高翔, 陈云霁, 吴为丹, 胡伟武. 一种复用二级Cache和DSP的RAM的方法及系统[P]. 北京: CN101446925, 2009-06-03.
[268]高翔, 陈云霁. 一种实现输入输出数据一致性的系统及方法[P]. 北京: CN101446931, 2009-06-03.
[269]王朋宇, 沈海华, 陈云霁. 一种微处理器验证中快速换页的装置和方法[P]. 北京: CN101441600, 2009-05-27.
[270]郇丹丹, 陈云霁, 李祖松, 高翔, 胡伟武. 一种多处理器系统及Cache一致性消息传输方法[P]. 北京: CN101430664, 2009-05-13.
[271]李晓钰, 高翔, 陈云霁. 一种集成芯片参数配置的系统及方法[P]. 北京: CN101430739, 2009-05-13.
发明授权:
[1]张蕊, 易琦, 彭少辉, 郭家明, 胡杏, 杜子东, 张曦珊, 郭崎, 陈云霁. 一种基于对象的强化学习方法及系统[P]. 北京市: CN117689912B, 2026-09-08.
[2]张蕊, 易琦, 彭少辉, 郭家明, 胡杏, 杜子东, 郭崎, 陈云霁. 一种捕捉环境中可控因素的表示学习方法及系统[P]. 北京市: CN117688983B, 2026-07-17.
[3]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵乘运算的装置和方法[P]. 北京市: CN111090467B, 2025-05-27.
[4]李震, 刘少礼, 陈天石, 陈云霁. 浮点数处理器[P]. 北京市: CN112230881B, 2025-04-04.
[5]韩栋, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量比较运算的装置和方法[P]. 北京市: CN111176608B, 2025-03-11.
[6]陈云霁, 刘少礼, 陈天石. 一种运算装置及其操作方法[P]. 北京市: CN112214244B, 2025-02-07.
[7]刘道福, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于生成服从一定分布的随机向量装置和方法[P]. 北京市: CN111857821B, 2025-01-28.
[8]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵加/减运算的装置和方法[P]. 北京市: CN111857820B, 2024-05-07.
[9]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580864B, 2024-05-07.
[10]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量外积运算的装置和方法[P]. 北京市: CN111651206B, 2024-05-07.
[11]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580866B, 2024-05-07.
[12]陶劲桦, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量四则运算的装置和方法[P]. 北京市: CN111651203B, 2024-05-07.
[13]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580863B, 2024-05-03.
[14]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵加/减运算的装置和方法[P]. 北京市: CN111857819B, 2024-05-03.
[15]陈云霁, 刘少礼, 陈天石. 一种运算装置及其操作方法[P]. 北京市: CN111857822B, 2024-04-05.
[16]支天, 刘少礼, 郭崎, 陈天石, 陈云霁. 一种用于执行向量最大值最小值运算的装置和方法[P]. 北京市: CN111651204B, 2024-04-05.
[17]陈云霁, 陈小兵, 刘少礼, 陈天石. 用于执行LSTM神经网络运算的装置和运算方法[P]. 上海市: CN113537480B, 2024-04-02.
[18]陈云霁, 陈小兵, 刘少礼, 陈天石. 用于执行LSTM神经网络运算的装置和运算方法[P]. 上海市: CN113537481B, 2024-04-02.
[19]陈云霁, 支天, 刘少礼, 郭崎, 陈天石. 一种用于执行卷积神经网络训练的装置和方法[P]. 北京市: CN111310904B, 2024-03-08.
[20]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络反向训练的装置和方法[P]. 北京市: CN111353588B, 2024-03-05.
[21]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN111353589B, 2024-03-01.
[22]陈云霁, 支天, 刘少礼, 郭崎, 陈天石. 一种用于执行卷积神经网络训练的装置和方法[P]. 北京市: CN111860812B, 2024-03-01.
[23]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量运算装置及运算方法[P]. 北京市: CN111580865B, 2024-02-27.
[24]刘少礼, 兰慧盈, 郭崎, 陈云霁, 陈天石. 一种用于执行人工神经网络全连接层正向运算的装置和方法[P]. 北京市: CN111860811B, 2024-01-16.
[25]刘少礼, 宋琎, 陈云霁, 陈天石. 一种用于执行人工神经网络pooling运算的装置和方法[P]. 北京市: CN111860772B, 2024-01-16.
[26]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种用于执行卷积神经网络正向运算的装置和方法[P]. 北京市: CN111860813B, 2024-01-16.
[27]刘少礼, 于涌, 陈云霁, 陈天石. 一种用于执行batch normalization运算的装置和方法[P]. 北京市: CN111860814B, 2024-01-16.
[28]韩栋, 郭崎, 陈天石, 陈云霁. 一种神经网络maxout层计算装置[P]. 北京市: CN112348182B, 2024-01-12.
[29]郭崎, 陈峋宇, 陈云霁, 陈天石. 用于执行LSTM运算的装置和方法[P]. 北京市: CN110929863B, 2023-11-28.
[30]支天, 郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量内积运算的装置和方法[P]. 北京市: CN111651205B, 2023-11-17.
[31]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量逻辑运算的装置[P]. 北京市: CN111651202B, 2023-09-22.
[32]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109656867B, 2023-05-16.
[33]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109634905B, 2023-03-10.
[34]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109634904B, 2023-03-07.
[35]高钰峰, 陈云霁. 一种利用人工智能芯片处理图像视频帧的方法[P]. 北京市: CN108921012B, 2022-05-03.
[36]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109376112B, 2022-03-15.
[37]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109376114B, 2022-03-15.
[38]张潇, 金禄旸, 张磊, 陈云霁. 基于小波变换压缩和/或解压缩的神经网络处理方法[P]. 北京市: CN108764454B, 2022-02-25.
[39]张士锦, 罗韬, 刘少礼, 陈云霁. 利用纠错码自动校正访问存储装置数据的装置及方法[P]. 北京市: CN108511028B, 2022-02-08.
[40]郭崎, 刘少礼, 陈云霁, 其他发明人请求不公开姓名. 矩阵乘加运算装置和方法、处理装置、芯片、电子装置[P]. 上海市: CN108205519B, 2022-01-25.
[41]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109376113B, 2021-12-14.
[42]杜子东, 郭崎, 陈天石, 陈云霁. 包括多个核心处理模块的人工神经网络的处理系统及方法[P]. 北京市: CN108510064B, 2021-12-10.
[43]兰慧盈, 郭崎, 陈云霁, 陈天石, 李尚应, 李震. 一种非线性函数运算装置及方法[P]. 北京市: CN107305484B, 2021-11-05.
[44]陈天石, 李韦, 郭崎, 陈云霁. 基于高带宽存储器的神经网络计算装置和方法[P]. 上海市: CN108241484B, 2021-10-15.
[45]陈天石, 刘少礼, 郭崎, 陈云霁. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109858623B, 2021-10-15.
[46]李震, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络自学习运算的装置和方法[P]. 北京市: CN110188870B, 2021-10-12.
[47]吴凡迪, 陈云霁. 一种进行神经网络运算的处理装置[P]. 北京市: CN108764465B, 2021-09-24.
[48]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109726168B, 2021-09-21.
[49]陈天石, 刘少礼, 陈云霁. 神经网络运算装置及方法[P]. 北京市: CN110298443B, 2021-09-17.
[50]张磊, 杜子东, 陈云霁. 脉冲神经网络转换方法及相关转换芯片[P]. 北京市: CN110059800B, 2021-09-14.
[51]张磊, 杜子东, 陈云霁. 脉冲神经网络运算芯片及相关运算方法[P]. 北京市: CN110059812B, 2021-09-14.
[52]陈云霁, 李尚应, 郭崎, 陈天石. 一种运算多种超越函数的装置[P]. 上海市: CN108228135B, 2021-09-07.
[53]陈云霁, 陈小兵, 刘少礼, 陈天石. 用于执行LSTM神经网络运算的装置和运算方法[P]. 上海市: CN108268939B, 2021-09-07.
[54]陈天石, 任逸轩, 郭崎, 杜子东, 支天, 陈云霁. 一种用于非精确计算神经网络的电路设计方法[P]. 上海市: CN108256642B, 2021-08-31.
[55]吴凡迪, 陈云霁. 一种人工神经网络运算的处理方法[P]. 北京市: CN108764470B, 2021-08-31.
[56]吴凡迪, 陈云霁. 一种人工智能芯片处理装置[P]. 北京市: CN108647781B, 2021-08-27.
[57]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109684267B, 2021-08-06.
[58]杜子东, 郭崎, 陈天石, 陈云霁. 用于乘加运算的人工神经网络的处理系统及方法[P]. 北京市: CN108416437B, 2021-08-03.
[59]张士锦, 郭崎, 陈天石, 陈云霁. 一种用于执行Hessian-Free训练算法的装置和方法[P]. 北京市: CN107341540B, 2021-07-20.
[60]张士锦, 李尚应, 陈天石, 陈云霁. 一种用于执行多种超越函数运算的装置和方法[P]. 北京市: CN107329732B, 2021-07-16.
[61]陈天石, 刘少礼, 郭崎, 陈云霁. 运算装置和方法[P]. 北京市: CN107340993B, 2021-07-16.
[62]刘少礼, 郭崎, 陈天石, 陈云霁. 一种用于执行RMSprop梯度下降算法的装置及方法[P]. 北京市: CN107315569B, 2021-06-18.
[63]郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行Adam梯度下降训练算法的装置及方法[P]. 北京市: CN107315570B, 2021-06-18.
[64]郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行AdaGrad梯度下降训练算法的装置和方法[P]. 北京市: CN107341132B, 2021-06-11.
[65]郭崎, 陈峋宇, 陈云霁, 陈天石. 用于执行循环神经网络和LSTM运算的装置和方法[P]. 北京市: CN107341542B, 2021-06-11.
[66]郭崎, 周聖元, 李震, 陈云霁, 陈天石. 一种用于执行多个浮点数相加的装置及方法[P]. 北京市: CN107305485B, 2021-06-08.
[67]刘少礼, 于涌, 陈云霁, 陈天石. 一种用于执行batch normalization运算的装置和方法[P]. 北京市: CN107341546B, 2021-06-08.
[68]杜子东, 郭崎, 陈天石, 陈云霁. 使用多核心处理模块进行神经网络划分的方法及其系统[P]. 北京市: CN108416436B, 2021-06-01.
[69]吴林阳, 郭雪婷, 陈云霁. 哈希混合加速系统及应用其进行哈希连接的方法[P]. 北京市: CN108182084B, 2021-05-11.
[70]李震, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络自学习运算的装置和方法[P]. 北京市: CN107316078B, 2021-05-07.
[71]陈云霁, 郝一帆, 刘少礼, 陈天石. 人工神经网络反向训练装置和方法[P]. 上海市: CN108205706B, 2021-04-23.
[72]金禄旸, 张潇, 张磊, 陈云霁. 基于压缩感知的神经网络处理系统及方法[P]. 北京市: CN108615074B, 2021-04-23.
[73]刘少礼, 于涌, 陈云霁, 陈天石. 支持离散数据表示的人工神经网络正向运算装置和方法[P]. 北京市: CN107301453B, 2021-04-20.
[74]陈云霁, 支天, 刘少礼, 郭崎, 陈天石. 一种用于执行卷积神经网络训练的装置和方法[P]. 北京市: CN107341547B, 2021-04-20.
[75]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN109697184B, 2021-04-09.
[76]吴林阳, 郭雪婷, 陈云霁. 哈希分区加速器[P]. 北京市: CN108196662B, 2021-03-30.
[77]张团, 陈云霁. 一种利用Volume R-CNN神经网络进行运算的方法和装置[P]. 北京市: CN108537329B, 2021-03-23.
[78]张团, 陈云霁. 一种用于执行Faster R-CNN神经网络运算的方法和装置[P]. 北京市: CN108597582B, 2021-02-12.
[79]周诗怡, 陈云霁. 智能摄像头及控制系统[P]. 北京市: CN109714526B, 2021-02-09.
[80]郭崎, 张士锦, 陈云霁, 陈天石. 一种用于执行全连接层神经网络训练的装置和方法[P]. 北京市: CN107341541B, 2021-01-29.
[81]郭崎, 于涌, 陈天石, 陈云霁. 支持离散数据表示的人工神经网络反向训练装置和方法[P]. 北京市: CN107301454B, 2021-01-22.
[82]张潇, 金禄旸, 张磊, 陈云霁. 基于主成分分析降维和/或升维的神经网络处理方法[P]. 北京市: CN108629410B, 2021-01-22.
[83]于涌, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 计数方法及装置[P]. 北京市: CN107818343B, 2021-01-08.
[84]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵乘运算的装置和方法[P]. 安徽省: CN107315574B, 2021-01-01.
[85]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵乘运算的装置和方法[P]. 安徽省: CN109240746B, 2020-12-18.
[86]刘少礼, 张潇, 陈云霁, 陈天石. 卷积运算装置及方法[P]. 安徽省: CN108388541B, 2020-12-11.
[87]吴林阳, 郭雪婷, 陈云霁. 含哈希分区加速器和内存的组合装置[P]. 北京市: CN108170253B, 2020-12-08.
[88]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络反向运算的装置和方法[P]. 北京市: CN110135581B, 2020-11-06.
[89]韩栋, 郭崎, 陈天石, 陈云霁. 一种神经网络maxout层计算装置[P]. 北京市: CN107305486B, 2020-11-03.
[90]刘道福, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量循环移位运算的装置和方法[P]. 北京市: CN107315566B, 2020-11-03.
[91]张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行矩阵加/减运算的装置和方法[P]. 北京市: CN107315715B, 2020-11-03.
[92]陶劲桦, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量四则运算的装置和方法[P]. 北京市: CN107315717B, 2020-11-03.
[93]陈云霁, 刘少礼, 陈天石. 一种运算装置及其操作方法[P]. 北京市: CN107688466B, 2020-11-03.
[94]李震, 刘少礼, 陈天石, 陈云霁. 一种浮点数处理装置和处理方法[P]. 北京市: CN106990937B, 2020-10-20.
[95]刘少礼, 兰慧盈, 郭崎, 陈云霁, 陈天石. 一种用于执行全连接层神经网络正向运算的装置和方法[P]. 北京市: CN109375951B, 2020-10-09.
[96]杜子东, 郭崎, 陈天石, 陈云霁. 神经网络加速器的片上缓存带宽均衡方法、系统及其装置[P]. 北京市: CN107203807B, 2020-10-02.
[97]刘少礼, 宋琎, 陈云霁, 陈天石. 用于执行pooling运算的装置和方法[P]. 北京市: CN107329733B, 2020-10-02.
[98]陈天石, 王秉睿, 张潇, 刘少礼, 陈云霁. 运算装置以及相关产品[P]. 上海市: CN107861757B, 2020-08-25.
[99]支天, 郭崎, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量内积运算的装置和方法[P]. 北京市: CN107315718B, 2020-08-21.
[100]陈天石, 刘少礼, 郭崎, 陈云霁. 一种人工神经网络压缩编码装置和方法[P]. 北京市: CN106991477B, 2020-08-14.
[101]韩栋, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量比较运算的装置和方法[P]. 北京市: CN107315563B, 2020-08-07.
[102]刘道福, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于生成服从一定分布的随机向量装置和方法[P]. 北京市: CN107315565B, 2020-08-07.
[103]支天, 刘少礼, 郭崎, 陈天石, 陈云霁. 一种用于执行向量最大值最小值运算的装置和方法[P]. 北京市: CN107315567B, 2020-08-07.
[104]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量逻辑运算的装置[P]. 北京市: CN107315568B, 2020-08-07.
[105]罗韬, 支天, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量外积运算的装置和方法[P]. 北京市: CN107315716B, 2020-08-07.
[106]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种用于执行卷积神经网络正向运算的装置和方法[P]. 北京市: CN107329734B, 2020-08-07.
[107]刘少礼, 兰慧盈, 郭崎, 陈云霁, 陈天石. 一种用于执行全连接层神经网络正向运算的装置和方法[P]. 北京市: CN107315571B, 2020-07-31.
[108]李震, 张潇, 刘少礼, 陈天石, 陈云霁. 一种用于执行向量合并运算的装置和方法[P]. 北京市: CN107315575B, 2020-07-31.
[109]刘少礼, 张潇, 陈云霁, 陈天石. 一种子矩阵运算装置及方法[P]. 北京市: CN107305538B, 2020-07-31.
[110]韩栋, 张潇, 陈天石, 陈云霁. 一种用于执行向量超越函数运算的装置和方法[P]. 北京市: CN107315564B, 2020-07-17.
[111]刘少礼, 于涌, 陈云霁, 陈天石. 支持离散数据表示的人工神经网络正向运算装置和方法[P]. 北京市: CN109358900B, 2020-07-03.
[112]陈云霁, 刘少礼, 郭崎, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109934331B, 2020-06-19.
[113]周聖元, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 神经网络运算装置及应用其进行运算的方法[P]. 北京市: CN108170640B, 2020-06-09.
[114]韩栋, 刘少礼, 陈云霁, 陈天石. 用于向量运算的数据读写调度器及保留站[P]. 北京市: CN106991073B, 2020-06-05.
[115]陈云霁, 李韦, 杜子东, 郭崎, 陈天石. 一种流执行方法及装置[P]. 上海市: CN106845631B, 2020-05-29.
[116]陈天石, 刘少礼, 郭崎, 陈云霁. 神经网络计算系统和方法[P]. 北京市: CN108427990B, 2020-05-22.
[117]陈天石, 张潇, 刘少礼, 陈云霁. 一种向量计算装置及运算方法[P]. 北京市: CN106990940B, 2020-05-22.
[118]陈天石, 支天, 罗宇哲, 刘少礼, 郭崎, 陈云霁. 基于深度自动编码器的视频编解码装置及方法[P]. 上海市: CN107046646B, 2020-05-22.
[119]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络反向训练的装置和方法[P]. 北京市: CN106991478B, 2020-05-08.
[120]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种卷积神经网络运算指令及其方法[P]. 北京市: CN107704267B, 2020-05-08.
[121]陈天石, 韩栋, 陈云霁, 刘少礼, 郭崎. 一种用于执行卷积神经网络正向运算的装置和方法[P]. 北京市: CN109086877B, 2020-05-08.
[122]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109242094B, 2020-05-08.
[123]郭崎, 张士锦, 陈云霁, 陈天石. 一种用于执行全连接层神经网络训练的装置和方法[P]. 北京市: CN109376861B, 2020-04-24.
[124]郭崎, 陈峋宇, 陈云霁, 陈天石. 用于执行LSTM运算的装置和方法[P]. 北京市: CN109284825B, 2020-04-14.
[125]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN106991476B, 2020-04-10.
[126]张磊, 金禄旸, 张潇, 陈云霁. 一种基于主成分分析减少IO开销的神经网络处理系统[P]. 北京市: CN108629409B, 2020-04-10.
[127]陈云霁, 杜子东, 张磊, 陈天石. SLAM运算装置和方法[P]. 北京市: CN108021528B, 2020-03-13.
[128]张磊, 金禄旸, 张潇, 陈云霁. 一种基于小波变换减少IO开销的神经网络处理系统[P]. 北京市: CN108665062B, 2020-03-10.
[129]张士锦, 罗韬, 刘少礼, 陈云霁. 一种用于DRAM或eDRAM刷新的装置及其方法[P]. 北京市: CN106856098B, 2020-02-28.
[130]陈天石, 刘少礼, 郭崎, 陈云霁. 一种执行人工神经网络运算的装置和方法[P]. 北京市: CN107886166B, 2020-02-21.
[131]刘少礼, 郭崎, 陈云霁, 陈天石. 用于执行人工神经网络正向运算的装置和方法[P]. 北京市: CN109993285B, 2020-02-07.
[132]高钰峰, 陈云霁. 基于LSTM网络模型的处理芯片与包含其的运算装置[P]. 北京市: CN108639882B, 2020-02-04.
[133]高钰峰, 陈云霁. 基于人工神经网络处理器的云端协同智能芯片[P]. 北京市: CN108675071B, 2020-01-17.
[134]陈云霁, 刘少礼, 韩栋, 陈天石. 一种用于执行神经网络运算的装置及方法[P]. 北京市: CN107688853B, 2020-01-10.
[135]刘少礼, 张潇, 陈云霁, 陈天石. 子矩阵运算装置及方法[P]. 北京市: CN108491359B, 2019-12-24.
[136]周聖元, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 可重构的S型运算装置及运算方法[P]. 北京市: CN107632965B, 2019-11-29.
[137]韩栋, 刘少礼, 陈云霁, 陈天石. 用于向量运算的数据读取、写入及读写调度器及保留站[P]. 北京市: CN108595371B, 2019-11-19.
[138]陈天石, 刘少礼, 陈云霁. 神经网络运算装置及方法[P]. 北京市: CN107886167B, 2019-11-08.
[139]于涌, 陈云霁, 陈天石, 刘少礼, 郭崎, 杜子东, 刘道福. 计数方法及装置[P]. 北京市: CN108052984B, 2019-11-08.
[140]于涌, 陈云霁. 基于N-GRAM和WFST模型的人工神经网络芯片及其应用方法[P]. 北京市: CN108364066B, 2019-11-08.
[141]于涌, 陈云霁. 一种基于深度神经网络的自动聊天方法和机器人[P]. 北京市: CN108388944B, 2019-10-18.
[142]高钰峰, 陈云霁. 基于神经网络的信息处理装置及方法[P]. 北京市: CN108545556B, 2019-10-01.
[143]陈天石, 杜子东, 郭崎, 陈云霁. 片上数据划分读写方法、系统及其装置[P]. 北京市: CN105843775B, 2018-12-04.
[144]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 加速深度神经网络算法的加速芯片的运算装置及方法[P]. 北京市: CN106529668B, 2018-12-04.
[145]张士锦, 罗韬, 刘少礼, 陈云霁. 一种用于自动校正访问存储装置数据的装置及方法[P]. 北京市: CN105609141B, 2018-08-10.
[146]杜子东, 郭崎, 陈天石, 陈云霁. 一种神经网络的处理方法、系统[P]. 北京市: CN105930902B, 2018-08-10.
[147]张士锦, 郭崎, 陈云霁, 陈天石. 一种用于稀疏连接的人工神经网络计算装置和方法[P]. 江苏省: CN105512723B, 2018-02-16.
[148]张士锦, 罗韬, 刘少礼, 陈云霁. 一种非线性函数的快速运算装置及其方法[P]. 北京市: CN105354006B, 2017-11-21.
[149]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 多输入多输出处理器流水线数据同步装置及方法[P]. 北京市: CN105824604B, 2017-08-29.
[150]罗韬, 刘少礼, 张士锦, 陈云霁. 一种分形树结构通信结构、方法、控制装置及智能芯片[P]. 北京市: CN105550157B, 2017-06-27.
[151]刘道福, 周圣元, 陈云霁. 硬件实现的数据排序装置、方法及数据处理芯片[P]. 北京市: CN105512179B, 2017-06-09.
[152]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 加法器装置、数据累加方法及数据处理装置[P]. 北京市: CN105512724B, 2017-05-10.
[153]罗韬, 刘少礼, 张士锦, 陈云霁. 分形树中向量数据回传处理单元的装置、方法、控制装置及智能芯片[P]. 北京市: CN105630733B, 2017-05-03.
[154]杜子东, 郭崎, 陈天石, 陈云霁. 一种神经网络加速器及其运算方法[P]. 北京市: CN105892989B, 2017-04-12.
[155]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 数据累加装置、方法及数字信号处理装置[P]. 北京市: CN105528191B, 2017-04-12.
[156]李震, 刘少礼, 张士锦, 罗韬, 钱诚, 陈云霁, 陈天石. 流水级运算装置、数据处理方法及片上网络芯片[P]. 北京市: CN105468335B, 2017-04-12.
[157]刘雨辰, 罗韬, 刘少礼, 张士锦, 陈云霁. 互连电路的数据处理装置和方法[P]. 北京市: CN105468546B, 2017-04-12.
[158]李磊, 陈云霁, 孙国庆. 并行程序的数据竞争检测方法、装置及多核处理系统[P]. 北京市: CN103488563B, 2017-04-12.
[159]罗韬, 刘少礼, 张士锦, 陈云霁. 基于分形树结构的数据发布装置、方法、控制装置及智能芯片[P]. 北京市: CN105634960B, 2017-04-05.
[160]刘少礼, 陈云霁, 陈天石, 李玲, 孙国庆. 网络拥塞信息传输方法和装置[P]. 北京市: CN103312603B, 2017-02-15.
[161]尹一笑, 陈云霁, 胡伟武. 一种提高动态冗余多线程性能和降低功耗开销的方法及系统[P]. 北京市: CN103699458B, 2017-02-01.
[162]王佳, 陈云霁, 尹夕振. 面向重放机制的缓存操作方法及装置[P]. 北京市: CN103744800B, 2016-09-14.
[163]李磊, 陈云霁, 尹夕振. 多核处理器及其并行重放方法[P]. 北京市: CN103970512B, 2016-09-14.
[164]王磊, 陈云霁, 陈天石, 陆超, 李梦竹. 一种异构多核线程调度方法、系统及异构多核处理器[P]. 北京市: CN103294550B, 2016-08-10.
[165]尹一笑, 陈云霁, 胡伟武. 一种降低处理器软错误率的方法和系统[P]. 北京市: CN103365731B, 2016-07-06.
[166]吴瑞阳, 陈云霁, 胡伟武, 杨梁. 指令执行流信息处理系统和装置及方法[P]. 北京市: CN102819419B, 2016-05-18.
[167]冯晓雪, 陈云霁, 李磊, 李梦竹. 基于确定性重放的并行系统弱一致性的验证方法和系统[P]. 北京市: CN103365776B, 2016-04-13.
[168]尹一笑, 陈云霁, 胡伟武. 一种降低多线程程序功耗的方法及系统[P]. 北京市: CN103336571B, 2016-02-03.
[169]尹一笑, 陈云霁, 胡伟武. 一种降低多线程程序功耗的方法及系统[P]. 北京市: CN103324269B, 2016-01-27.
[170]李磊, 陈云霁, 孙国庆. 一种基于确定性重放的处理器整体故障检测系统与方法[P]. 北京市: CN102591763B, 2015-03-04.
[171]刘少礼, 李玲, 陈云霁. 一种视频编解码访存优化系统和方法[P]. 北京市: CN102769755B, 2015-02-25.
[172]刘道福, 陈云霁, 郭崎, 胡伟武. 缓存预测执行的处理器与装置及方法[P]. 北京市: CN102841857B, 2015-02-25.
[173]王磊, 刘道福, 陈云霁, 郭崎, 张戈. 一种弱一致性存储模型的数据访存系统和方法[P]. 北京市: CN102591800B, 2015-01-07.
[174]陈云霁, 陆超, 钟石强. 片上网络路由集中控制系统和装置及自适应路由控制方法[P]. 北京市: CN102546406B, 2014-08-20.
[175]刘道福, 李玲, 钱诚, 陈云霁. 实现H.264的CAVLC的熵解码器和方法[P]. 北京市: CN102710937B, 2014-08-20.
[176]李磊, 陈云霁, 苏孟豪. 在处理器中控制不同锁相环输出时钟的控制系统和方法[P]. 北京市: CN102394641B, 2014-08-06.
[177]尹一笑, 陈云霁, 郭崎, 杨旭. 片上网络多核处理器多线程的资源分配处理方法和系统[P]. 北京市: CN102591722B, 2014-06-25.
[178]王玲, 高翔, 陈云霁. 矩阵转置自动控制电路系统及矩阵转置方法[P]. 北京市: CN101706760B, 2013-07-31.
[179]胡伟武, 刘宏伟, 陈云霁. 一种多媒体变换乘法器及其处理方法[P]. 北京市: CN102043605B, 2012-10-24.
[180]王朋宇, 陈云霁, 沈海华, 胡伟武. 一种微处理器指令级随机验证中加速取指的装置和方法[P]. 北京市: CN101819608B, 2012-09-05.
[181]李向库, 齐子初, 马麟, 李晓钰, 陈云霁, 胡伟武. 一种处理器芯片频率的筛选方法[P]. 北京市: CN101839962B, 2012-06-27.
[182]苏孟豪, 陈云霁. 一种多时钟数字系统及其时钟确定装置和方法[P]. 北京市: CN101739500B, 2012-06-06.
[183]苏孟豪, 陈云霁. 一种支持处理器硅后调试的装置和方法[P]. 北京市: CN101714114B, 2012-05-23.
[184]胡伟武, 吴瑞阳, 钱诚, 陈云霁. 实现多核处理器EJTAG可调试性的装置及系统[P]. 北京市: CN101710300B, 2011-11-02.
[185]钱诚, 陈云霁, 王玲. 一种DMA控制器的控制装置及控制方法[P]. 北京市: CN101702144B, 2011-10-26.
[186]陈云霁, 钱诚. 包含四条指令的支持快速傅里叶变换运算的方法[P]. 北京市: CN101706770B, 2011-10-26.
[187]胡伟武, 陈云霁, 朱海涛. 浮点向量乘加运算装置和方法[P]. 北京市: CN101706712B, 2011-08-31.
[188]高翔, 陈云霁. 一种实现输入输出数据一致性的系统及方法[P]. 北京市: CN101446931B, 2010-12-08.
[189]李晓钰, 高翔, 陈云霁. 一种集成芯片参数配置的系统及方法[P]. 北京市: CN101430739B, 2010-12-08.
[190]王朋宇, 沈海华, 陈云霁. 一种微处理器验证中快速换页的装置和方法[P]. 北京市: CN101441600B, 2010-12-08.
[191]高翔, 陈云霁, 吴为丹, 胡伟武. 一种复用二级Cache和DSP的RAM的方法及系统[P]. 北京市: CN101446925B, 2010-10-06.
[192]郇丹丹, 陈云霁, 李祖松, 高翔, 胡伟武. 一种多处理器系统及Cache一致性消息传输方法[P]. 北京市: CN101430664B, 2010-07-28.
[193]胡伟武, 陈云霁, 钱诚. 一种门控时钟系统及其工作方法[P]. 北京市: CN101446842B, 2010-04-21.
英文期刊文章:
[1] Automated Superscalar Processor Design by Learning Data Dependencies, IJCAI-2025, 2025, 第 13 作者 通讯作者
[2] QiMeng-Attention: SOTA Attention Operator is generated by SOTA Attention Algorithm, ACL 2025, 2025, 第 13 作者
[3] QiMeng-Xpiler: Transcompiling Tensor Programs for Deep Learning Systems with a Neural-Symbolic Approach, OSDI 2025, 2025, 第 14 作者
[4] QiMeng-TensorOp: One-Line Prompt is Enough for High-Performance Tensor Operator Generation with Hardware Primitives, Thirty-Fourth International Joint Conference on Artificial Intelligence (IJCAI-25), 2025, 第 14 作者
[5] QiMeng-GEMM: Automatically Generating High-Performance Matrix Multiplication Code by Exploiting Large Language Models, AAAI Conference on Artificial Intelligence (AAAI), 2025, 第 9 作者
[6] Morphology Generalizable Reinforcement Learning via Multi-level Graph Features, Neurocomputing, 2025, 第 17 作者
[7] AI Computing Systems for Large Language Models Training, Journal of Computer Science and Technology, 2024, 第 12 作者 通讯作者
[8] InverseCoder: Self-improving Instruction-Tuned Code LLMs with Inverse-Instruct, AAAI 2025, 2024, 第 16 作者 通讯作者
[9] OCEAN-MBRL: Offline Conservative Exploration for Model-Based Offline Reinforcement Learning, AAAI Conference on Artificial Intelligence (AAAI), 2024, 第 13 作者
[10] Automated CPU Design by Learning from Input-Output Examples, IJCAI-24, 2024, 第 17 作者 通讯作者
[11] Prompt-based Visual Alignment for Zero-shot Policy Transfer, ICML 2024, 2024, 第 16 作者 通讯作者
[12] Emergent Communication for Numerical Concepts Generalization, AAAI-24, 2024, 第 16 作者 通讯作者
[13] Introducing Compiler Semantics into Large Language Models as Programming Language Translators: A Case Study of C to x86 Assembly, EMNLP 2024, 2024, 第 5 作者
[14] Hypothesis, Verification, and Induction: Grounding Large Language Models with Self-Driven Skill Learning, AAAI-24, 2024, 第 11 作者
[15] Online Prototype Alignment for Few-shot Policy Transfer, International Conference on Minority Languages (ICML XVI), 2023, 第 2 作者 通讯作者
[16] Conceptual Reinforcement Learning for Language-Conditioned Tasks, AAAI Conference on Artificial Intelligence (AAAI), 2023, 第 10 作者 通讯作者
[17] BALTO: fast tensor program optimization with diversity-based active learning, ICLR 2023, 2023, 第 10 作者
[18] Rescue to the Curse of universality, SCIENCE CHINA-INFORMATION SCIENCES, 2023, 第 5 作者 通讯作者
[19] Online Symbolic Regression with Informative Query, AAAI Conference on Artificial Intelligence (AAAI), 2023, 第 2 作者 通讯作者
[20] Learning controllable elements oriented representations for reinforcement learning, NEUROCOMPUTING, 2023, 第 10 作者
[21] BabelTower: Learning to Auto-parallelized Program Translation, Proceedings of the 39 th International Conference on Machine Learning, 2022, 第 13 作者 通讯作者
[22] Object-Category Aware Reinforcement Learning, NeurIPS 2022, 2022, 第 9 作者 通讯作者
[23] Neural Program Synthesis with Query, ICLR 2022, 2022, 第 9 作者
[24] Tetris: A Heuristic Static Memory Management Framework for Uniform Memory Multicore Neural Network Accelerators, Tetris: A Heuristic Static Memory Management Framework for Uniform Memory Multicore Neural Network Accelerators, Journal of Computer Science and Technology, 2022, 第 6 作者
[25] Cambricon-G: A Polyvalent Energy-Efficient Accelerator for Dynamic Graph Neural Networks, IEEE TRANSACTIONS ON COMPUTER-AIDED DESIGN OF INTEGRATED CIRCUITS AND SYSTEMS, 2022, 第 10 作者 通讯作者
[26] Causality-driven Hierarchical Structure Discovery for Reinforcement Learning, NeurIPS 2022, 2022, 第 12 作者 通讯作者
[27] Accelerating Sparse Convolution with Column Vector-Wise Sparsity, NeurIPS 2022, 2022, 第 6 作者
[28] Zidong Du, Qi Guo, Yongwei Zhao, Xi Zeng, Ling Li, Limin Cheng, Zhiwei Xu, Ninghui Sun, Yunji Chen*: Breaking the Interaction Wall: A DLPU-Centric Deep Learning Computing System. IEEE Transactions on Computers 71(1): 209-222(2022)通讯作者
[29] Xinkai Song, Tian Zhi, Zhe Fan, Zhenxing Zhang, Xi Zeng, Wei Li, Xing Hu, Zidong Du, Qi Guo, Yunji Chen: Cambricon-G: A Polyvalent Energy-Efficient Accelerator for Dynamic Graph Neural Networks. IEEE Trans. Comput. Aided Des. Integr. Circuits Syst. 41(1): 116-128(2022)
[30] Zhenxing Zhang, Shiyan Sun, Xunyu Chen, Tian Zhi, Qi Guo, Yunji Chen: Space-address decoupled scratchpad memory management for neural network accelerators.CONCURRENCY AND COMPUTATION-PRACTICE & EXPERIENCE. 33(6) (2021)
[31] Di Huang, Rui Zhang, Xishan Zhang, Fan Wu, Xianzhuo Wang, Pengwei Jin, Shaoli Liu, Ling Li, Yunji Chen: A Decomposable Winograd Method for N-D Convolution Acceleration in Video Analysis. INTERNATIONAL JOURNAL OF COMPUTER VISION. 129(10): 2806-2826 (2021)
[32] ScaleCert: Scalable Certified Defense against Adversarial Patches with Sparse Superficial Layers, 2021, 第 9 作者
[33] Cambricon-G: A Polyvalent Energy-efficient Accelerator for Dynamic Graph Neural Networks, IEEE TRANSACTIONS ON COMPUTER-AIDED DESIGN OF INTEGRATED CIRCUITS AND SYSTEMS, 2021, 第 10 作者 通讯作者
[34] Distilling Object Detectors with Feature Richness, 2021, 第 7 作者
[35] Hindsight Value Function for Variance Reduction in Stochastic Dynamic Environment, 2021, 第 9 作者
[36] Zidong Du, Qi Guo, Yongwei Zhao, Tian Zhi, Yunji Chen, Zhiwei Xu: Self-Aware Neural Network Systems: A Survey and New Perspective. Proc. IEEE 108(7): 1047-1067 (2020) 通讯作者
[37] Xi Zeng, Tian Zhi, Xuda Zhou, Zidong Du, Qi Guo, Shaoli Liu, Bingrui Wang, Yuanbo Wen, Chao Wang, Xuehai Zhou, Ling Li, Tianshi Chen, Ninghui Sun, Yunji Chen: Addressing Irregularity in Sparse Neural Networks Through a Cooperative Software/Hardware Approach. IEEE Trans. Computers69(7): 968-985 (2020)通讯作者
[38] Yongwei Zhao, Zhe Fan, Zidong Du, Tian Zhi, Ling Li, Qi Guo, Shaoli Liu, Zhiwei Xu, Tianshi Chen, Yunji Chen: Machine Learning Computers With Fractal von Neumann Architecture. IEEE Trans. Computers 69(7): 998-1014 (2020)
[39] Shengyuan Zhou, Qi Guo, Zidong Du, Dao-Fu Liu, Tianshi Chen, Ling Li, Shaoli Liu, Jinhong Zhou, Olivier Temam, Xiaobing Feng, Xuehai Zhou, Yunji Chen: ParaML: A Polyvalent Multicore Accelerator for Machine Learning.IEEE Trans. Comput. Aided Des. Integr. Circuits Syst. 39(9): 1764-1777(2020)
[40] Fixed-Point Back-Propagation Training, 2020 IEEE/CVF CONFERENCE ON COMPUTER VISION AND PATTERN RECOGNITION (CVPR), 2020, 第 11 作者
[41] Yong Yu, Tian Zhi, Xuda Zhou, Shaoli Liu, Yunji Chen, Shuyao Cheng: BSHIFT: A Low Cost Deep Neural Networks Accelerator. Int. J. Parallel Program. 47(3): 360-372 (2019)
[42] Bingsheng He, Yunji Chen, Jingren Zhou: Guest Editors' Introduction: Special Issue on Big Data Systems on Emerging Architectures. IEEE Trans. Big Data 5(1): 2-3 (2019)
[43] Xuda Zhou, Zidong Du, Shijin Zhang, Lei Zhang, Huiying Lan, Shaoli Liu, Ling Li, Qi Guo, Tianshi Chen, Yunji Chen: Addressing Sparsity in Deep Neural Networks. IEEE Trans. Comput. Aided Des. Integr. Circuits Syst. 38(10): 1858-1871 (2019)通讯作者
[44] Yunji Chen, Huiying Lan, Zidong Du, Shaoli Liu, Jinhua Tao, Dong Han, Tao Luo, Qi Guo, Ling Li, Yuan Xie, Tianshi Chen: An Instruction Set Architecture for Machine Learning. ACM Trans. Comput. Syst. 36(3): 9:1-9:35 (2019)
(44) Cambricon-F: Machine Learning Computers with Fractal von Neumann Architecture, PROCEEDINGS OF THE 2019 46TH INTERNATIONAL SYMPOSIUM ON COMPUTER ARCHITECTURE (ISCA '19), 2019, 第 8 作者 通讯作者
(45) TDSNN: From Deep Neural Networks to Deep Spike Neural Networks with Temporal-Coding, THIRTY-THIRD AAAI CONFERENCE ON ARTIFICIAL INTELLIGENCE / THIRTY-FIRST INNOVATIVE APPLICATIONS OF ARTIFICIAL INTELLIGENCE CONFERENCE / NINTH AAAI SYMPOSIUM ON EDUCATIONAL ADVANCES IN ARTIFICIAL INTELLIGENCE, 2019, 第 5 作者 通讯作者
(52) TDSNN:from DNN to deep SNN with temporal coding, AAAI Conference on Artificial Intelligence, 2019, 第 1 作者 通讯作者
[45] Jinhua Tao, Zidong Du, Qi Guo, Huiying Lan, Lei Zhang, Shengyuan Zhou, Ling-Jie Xu, Cong Liu, Hai-Feng Liu, Shan Tang, Allen Rush, Willian Chen, Shaoli Liu, Yunji Chen, Tianshi Chen: BenchIP: Benchmarking Intelligence Processors. Journal of Computer Science and Technology. 33(1): 1-23 (2018)
[14] Zhe Wang, Chenggang Wu, Xiang Yuan, Zhenjiang Wang, Jianjun Li, Pen-Chung Yew, Jeff Huang, Xiaobing Feng, Yanyan Lan, Yunji Chen, Yuanming Lai, Yong Guan: Using Local Clocks to Reproduce Concurrency Bugs.IEEE TRANSACTIONS ON SOFTWARE ENGINEERING (CCF A). 44(11): 1112-1128 (2018)
(55) Addressing Sparisity in Deep Neural Networks, IEEE Trans. on CAD of Integrated Circuits and Systems, 2018, 第 1 作者
(56) Cambricon-S: Addressing Irregularity in Sparse Neural Networks through A Cooperative Software/Hardware Approach, 2018 51ST ANNUAL IEEE/ACM INTERNATIONAL SYMPOSIUM ON MICROARCHITECTURE (MICRO), 2018, 第 10 作者 通讯作者
[15] Huiying Lan, Linyang Wu, Xiao Zhang, Jinhua Tao, Xunyu Chen, Bingrui Wang, Yu-Qing Wang, Qi Guo, Yunji Chen: DLPlib: A Library for Deep Learning Processor. Journal of Computer Science and Technology. 32(2): 286-296 (2017)
[16] Tao Luo, Shaoli Liu, Ling Li, Yuqing Wang, Shijin Zhang, Tianshi Chen, Zhiwei Xu, Olivier Temam, Yunji Chen: DaDianNao: A Neural Network Supercomputer. IEEE TRANSACTIONS ON COMPUTERS. 66(1): 73-88 (2017) 通讯作者
[17] Zidong Du, Shaoli Liu, Robert Fasthuber, Tianshi Chen, Paolo Ienne, Ling Li, Tao Luo, Qi Guo, Xiaobing Feng, Yunji Chen, Olivier Temam: An Accelerator for High Efficient Vision Processing. IEEE TRANSACTIONS ON COMPUTER-AIDED DESIGN OF INTEGRATED CIRCUITS AND SYSTEMS. 36(2): 227-240 (2017)
[18] Yubin Xia, Yutao Liu, Haibing Guan, Yunji Chen, Tianshi Chen, Binyu Zang, Haibo Chen: Secure Outsourcing of Virtual Appliance.IEEE TRANSACTIONS ON CLOUD COMPUTING.5(3): 390-404 (2017)
[19] Chao Wang, Xi Li, Yunji Chen, Youhui Zhang, Oliver Diessel, Xuehai Zhou: Service-Oriented Architecture on FPGA-Based MPSoC. IEEE TRANSACTIONS ON PARALLEL AND DISTRIBUTED SYSTEMS. 28(10): 2993-3006 (2017)
[20] Yunji Chen, Tianshi Chen, Zhiwei Xu, Ninghui Sun, Olivier Temam: DianNao family: energy-efficient hardware accelerators for machine learning. Commun. ACM 59(11): 105-112 (2016)
[21] Yue Wu, Chao Lu, Yunji Chen: A survey of routing algorithm for mesh Network-on-Chip. Frontiers Comput. Sci. 10(4): 591-601 (2016)
[22] Babak Falsafi, Mircea Stan, Kevin Skadron, Nuwan Jayasena, Yunji Chen, Jinhua Tao, Ravi Nair, Jaime H. Moreno, Naveen Muralimanohar, Karthikeyan Sankaralingam, Cristian Estan: Near-Memory Data Services. IEEE Micro 36(1): 6-13 (2016)
[23] Qi Guo, Tianshi Chen, Yunji Chen, Franz Franchetti: Accelerating Architectural Simulation Via Statistical Techniques: A Survey. IEEE Trans. Comput. Aided Des. Integr. Circuits Syst. 35(3): 433-446 (2016)
[24] Shaoli Liu, Tianshi Chen, Ling Li, Xiaoxue Feng, Zhiwei Xu, Haibo Chen, Frederic T. Chong, Yunji Chen: IMR: High-Performance Low-Cost Multi-Ring NoCs. IEEE Trans. Parallel Distributed Syst. 27(6): 1700-1712 (2016)
[25] Yunji Chen, Shijin Zhang, Qi Guo, Ling Li, Ruiyang Wu, Tianshi Chen: Deterministic Replay: A Survey. ACM Comput. Surv. 48(2): 17:1-17:47(2015)
[26] Tianshi Chen, Zidong Du, Ninghui Sun, Jia Wang, Chengyong Wu, Yunji Chen, Olivier Temam: A High-Throughput Neural Network Accelerator. IEEE Micro 35(3): 24-32 (2015)
[27] Shuangde Fang, Wenwen Xu, Yang Chen, Lieven Eeckhout, Olivier Temam, Yunji Chen, Chengyong Wu, Xiaobing Feng: Practical Iterative Optimization for the Data Center. ACM Trans. Archit. Code Optim. 12(2): 15:1-15:26 (2015)
[28] Chao Wang, Xi Li, Junneng Zhang, Peng Chen, Yunji Chen, Xuehai Zhou, Ray C. C. Cheung: Architecture Support for Task Out-of-Order Execution in MPSoCs.IEEE Trans. Computers 64(5): 1296-1310 (2015)
[29] Tianshi Chen, Qi Guo, Olivier Temam, Yue Wu, Yungang Bao, Zhiwei Xu, Yunji Chen: Statistical Performance Comparisons of Computers. IEEE Trans. Computers 64(5): 1442-1455 (2015)
[30] Zidong Du, Avinash Lingamneni, Yunji Chen, Krishna V. Palem, Olivier Temam, Chengyong Wu: Leveraging the Error Resilience of Neural Networks for Designing Highly Energy Efficient Accelerators. IEEE Trans. Comput. Aided Des. Integr. Circuits Syst. 34(8): 1223-1235 (2015)
[31] Tianshi Chen, Shijin Zhang, Shaoli Liu, Zidong Du, Tao Luo, Yuan Gao, Junjie Liu, Dongsheng Wang, Chengyong Wu, Ninghui Sun, Yunji Chen, Olivier Temam: A Small-Footprint Accelerator for Large-Scale Neural Networks.ACM Trans. Comput. Syst. 33(2): 6:1-6:27 (2015)
[32] Qi Guo, Tianshi Chen, Zhi-Hua Zhou, Olivier Temam, Ling Li, Depei Qian, Yunji Chen: Robust Design Space Modeling. ACM Trans. Design Autom. Electr. Syst.20(2): 18:1-18:22 (2015)
[33] Shaoli Liu, Tianshi Chen, Ling Li, Xi Li, Mingzhe Zhang, Chao Wang, Haibo Meng, Xuehai Zhou, Yunji Chen: FreeRider: Non-Local Adaptive Network-on-Chip Routing with Packet-Carried Propagation of Congestion Information. IEEE Trans. Parallel Distributed Syst. 26(8): 2272-2285 (2015)
(77) Deterministic Replay: A Survey, ACM COMPUTING SURVEYS, 2015, 第 1 作者
(81) Robust Design Space Modeling, ACM TRANSACTIONS ON DESIGN AUTOMATION OF ELECTRONIC SYSTEMS, 2015, 第 7 作者 通讯作者
(82) Architecture Support for Task Out-of-Order Execution in MPSoCs, IEEE TRANSACTIONS ON COMPUTERS, 2015, 第 5 作者
(83) Leveraging the Error Resilience of Neural Networks for Designing Highly Energy Efficient Accelerators, IEEE TRANSACTIONS ON COMPUTER-AIDED DESIGN OF INTEGRATED CIRCUITS AND SYSTEMS, 2015, 第 3 作者
(84) Robust Architectural Design Space Modeling, ACM Transactions on Design Automation of Electronic Systems, 2015, 第 7 作者 通讯作者
(87) Statistical Performance Comparisons of Computers, IEEE TRANSACTIONS ON COMPUTERS, 2015, 第 7 作者
(89) Reproducing Concurrency Bugs Using Local Clocks, ACM/IEEE 37th International Conference on Software Engineering (ICSE 2015) (CCF A), 2015, 第 9 作者
(92) FreeRider: Non-Local Adaptive Network-on-Chip Routing with Packet-Carried Propagation of Congestion Information, IEEE TRANSACTIONS ON PARALLEL AND DISTRIBUTED SYSTEMS, 2015, 第 9 作者
(93) A Small-Footprint Accelerator for Large-Scale Neural Networks, ACM TRANSACTIONS ON COMPUTER SYSTEMS, 2015, 第 11 作者 通讯作者
(94) Practical Iterative Optimization for the Data Center, ACM TRANSACTIONS ON ARCHITECTURE AND CODE OPTIMIZATION, 2015, 第 6 作者
[34] Shaoli Liu, Ling Li, Yunji Chen, Weiwu Hu: Auxiliary stream for optimizing memory access of video decoders.Sci. China Inf. Sci. 57(1): 1-10 (2014)
[35] Yue Wu, Yunji Chen, Tianshi Chen, Qi Guo, Lei Zhang: An Elastic Architecture Adaptable to Various Application Scenarios.J. Comput. Sci. Technol. 29(2): 227-238 (2014)
[36] Peng Chen, Lei Zhang, Yinhe Han, Yunji Chen: A General-Purpose Many-Accelerator Architecture Based on Dataflow Graph Clustering of Applications. J. Comput. Sci. Technol.29(2): 239-246 (2014)
[37] Yi-Xiao Yin, Yunji Chen, Qi Guo, Tianshi Chen: Prevention from Soft Errors via Architecture Elasticity. J. Comput. Sci. Technol. 29(2): 247-254 (2014)
[38] Weiwu Hu, Liang Yang, Bao-Xia Fan, Huandong Wang, Yunji Chen: An 8-Core MIPS-Compatible Processor in 32/28 nm Bulk CMOS. IEEE J. Solid State Circuits 49(1): 41-49 (2014)
[39] Shuangde Fang, Zidong Du, Yuntan Fang, Yuanjie Huang, Yang Chen, Lieven Eeckhout, Olivier Temam, Huawei Li, Yunji Chen, Chengyong Wu: Performance Portability Across Heterogeneous SoCs Using a Generalized Library-Based Approach. ACM Trans. Archit. Code Optim.11(2): 21:1-21:25 (2014)
[40] Qi Guo, Tianshi Chen, Yunji Chen, Rui Wang, Huanhuan Chen, Weiwu Hu, Guoliang Chen: Pre-Silicon Bug Forecast. IEEE Trans. Comput. Aided Des. Integr. Circuits Syst. 33(3): 451-463 (2014)
(109) Effective and Efficient Microprocessor Design Space Exploration Using Unlabeled Design Configurations, ACM TRANSACTIONS ON INTELLIGENT SYSTEMS AND TECHNOLOGY, 2013, 第 2 作者
(110) LDet: Determinizing Asynchronous Transfer for Postsilicon Debugging, IEEE TRANSACTIONS ON COMPUTERS, 2013, 第 1 作者 通讯作者
(111) Motion Estimation Without Integer-Pel Search, IEEE TRANSACTIONS ON IMAGE PROCESSING, 2013, 第 3 作者
(112) Deterministic Replay Using Global Clock, ACM TRANSACTIONS ON ARCHITECTURE AND CODE OPTIMIZATION, 2013, 第 1 作者
(113) Microarchitectural design space exploration made fast, MICROPROCESSORS AND MICROSYSTEMS, 2013, 第 3 作者
会议文章:
[1] Jiaming Guo, Rui Zhang, Xishan Zhang, Shaohui Peng, Qi Yi, Zidong Du, Xing Hu, Qi Guo, Yunji Chen: Hindsight Value Function for Variance Reduction in Stochastic Dynamic Environment. IJCAI 2021: 2476-2482
[2] Zhixing Du, Rui Zhang, Ming Chang, Xishan Zhang, Shaoli Liu, Tianshi Chen, Yunji Chen: Distilling Object Detectors with Feature Richness. NeurIPS 2021: 5213-5224
[3] Husheng Han, Kaidi Xu, Xing Hu, Xiaobing Chen, Ling Liang, Zidong Du, Qi Guo, Yanzhi Wang, Yunji Chen: ScaleCert: Scalable Certified Defense against Adversarial Patches with Sparse Superficial Layers. NeurIPS 2021: 28169-28181
[4] Di Huang, Xishan Zhang, Rui Zhang, Tian Zhi, Deyuan He, Jiaming Guo, Chang Liu, Qi Guo, Zidong Du, Shaoli Liu, Tianshi Chen, Yunji Chen: DWM: A Decomposable Winograd Method for Convolution Acceleration. AAAI 2020: 4174-4181
[5] Xishan Zhang, Shaoli Liu, Rui Zhang, Chang Liu, Di Huang, Shiyi Zhou, Jiaming Guo, Qi Guo, Zidong Du, Tian Zhi, Yunji Chen: Fixed-Point Back-Propagation Training. CVPR 2020: 2327-2335
[6] Xi Zeng, Tian Zhi, Zidong Du, Qi Guo, Ninghui Sun, Yunji Chen: ALT: Optimizing Tensor Compilation in Deep Learning Compilers with Active Learning.2020 IEEE 38TH INTERNATIONAL CONFERENCE ON COMPUTER DESIGN ICCD 2020: 623-630
(37) Fixed-Point Back-Propagation Training, 2020 IEEE/CVF CONFERENCE ON COMPUTER VISION AND PATTERN RECOGNITION (CVPR), 2020, 第 11 作者
(42) ParaML: A Polyvalent Multicore Accelerator for Machine Learning, IEEE TRANSACTIONS ON COMPUTER-AIDED DESIGN OF INTEGRATED CIRCUITS AND SYSTEMS, 2020, 第 12 作者
[7] Lei Zhang, Shengyuan Zhou, Tian Zhi, Zidong Du, Yunji Chen: TDSNN: From Deep Neural Networks to Deep Spike Neural Networks with Temporal-Coding. AAAI 2019: 1319-1326
[8] Yongwei Zhao, Zidong Du, Qi Guo, Shaoli Liu, Ling Li, Zhiwei Xu, Tianshi Chen, Yunji Chen: Cambricon-F: machine learning computers with fractal von neumann architecture. ISCA 2019: 788-801
[9] Xuda Zhou, Zidong Du, Qi Guo, Shaoli Liu, Chengsi Liu, Chao Wang, Xuehai Zhou, Ling Li, Tianshi Chen, Yunji Chen: Cambricon-S: Addressing Irregularity in Sparse Neural Networks through A Cooperative Software/Hardware Approach. MICRO 2018: 15-28
[10] Jinhong Zhou, Shaoli Liu, Qi Guo, Xuda Zhou, Tian Zhi, Dao-Fu Liu, Chao Wang, Xuehai Zhou, Yunji Chen, Tianshi Chen: TuNao: A High-Performance and Energy-Efficient Reconfigurable Accelerator for Graph Processing. 2017 17TH IEEE/ACM INTERNATIONAL SYMPOSIUM ON CLUSTER, CLOUD AND GRID COMPUTING (CCGRID), 2017: 731-734
[11] Shaoli Liu, Zidong Du, Jinhua Tao, Dong Han, Tao Luo, Yuan Xie, Yunji Chen, Tianshi Chen: Cambricon: An Instruction Set Architecture for Neural Networks.Computer Architecture (ISCA), 2016 ACM/IEEE 43rd Annual International Symposium on, 2016: 393-405 通讯作者
[12] Shijin Zhang, Zidong Du, Lei Zhang, Huiying Lan, Shaoli Liu, Ling Li, Qi Guo, Tianshi Chen, Yunji Chen: Cambricon-X: An accelerator for sparse neural networks. 2016 49TH ANNUAL IEEE/ACM INTERNATIONAL SYMPOSIUM ON MICROARCHITECTURE (MICRO),2016: 20:1-20:12
(68) Accelerating Architectural Simulation Via Statistical Techniques: A Survey, IEEE TRANSACTIONS ON COMPUTER-AIDED DESIGN OF INTEGRATED CIRCUITS AND SYSTEMS, 2016, 第 3 作者 通讯作者
(69) DianNao Family: Energy-Efficient Hardware Accelerators for Machine Learning, COMMUNICATIONS OF THE ACM, 2016, 第 1 作者 通讯作者
(71) A survey of routing algorithm for mesh Network-on-Chip, FRONTIERS OF COMPUTER SCIENCE, 2016, 第 3 作者 通讯作者
(72) Near-Data Processing of Neural Networks, IEEE MICRO, 2016, 第 1 作者 通讯作者
(76) IMR: High-Performance Low-Cost Multi-Ring NoCs, IEEE TRANSACTIONS ON PARALLEL AND DISTRIBUTED SYSTEMS, 2016, 第 8 作者 通讯作者
[13] Dao-Fu Liu, Tianshi Chen, Shaoli Liu, Jinhong Zhou, Shengyuan Zhou, Olivier Temam, Xiaobing Feng, Xuehai Zhou, Yunji Chen: PuDianNao: A Polyvalent Machine Learning Accelerator. ASPLOS2015: 369-381
[14] Xiaochun Zhang, Qi Guo, Yunji Chen, Tianshi Chen, Weiwu Hu: HERMES: a fast cross-ISA binary translator with post-optimization.2015 IEEE/ACM INTERNATIONAL SYMPOSIUM ON CODE GENERATION AND OPTIMIZATION (CGO), 2015: 246-256
[15] Jiachao Deng, Yuntan Fang, Zidong Du, Ying Wang, Huawei Li, Olivier Temam, Paolo Ienne, David Novo, Xiaowei Li, Yunji Chen, Chengyong Wu: Retraining-based timing error mitigation for hardware neural networks. 2015 DESIGN, AUTOMATION & TEST IN EUROPE CONFERENCE & EXHIBITION (DATE), 2015: 593-596
[16] Xiang Yuan, Chenggang Wu, Zhenjiang Wang, Jianjun Li, Pen-Chung Yew, Jeff Huang, Xiaobing Feng, Yanyan Lan, Yunji Chen, Yong Guan: ReCBuLC: Reproducing Concurrency Bugs Using Local Clocks.International Conference on Software Engineering, (1)2015: 824-834
[17] Zidong Du, Robert Fasthuber, Tianshi Chen, Paolo Ienne, Ling Li, Tao Luo, Xiaobing Feng, Yunji Chen, Olivier Temam: ShiDianNao: shifting vision processing closer to the sensor. 2015 ACM/IEEE 42ND ANNUAL INTERNATIONAL SYMPOSIUM ON COMPUTER ARCHITECTURE (ISCA),2015: 92-104
[18] Zidong Du, Daniel D. Ben-Dayan Rubin, Yunji Chen, Liqiang He, Tianshi Chen, Lei Zhang, Chengyong Wu, Olivier Temam: Neuromorphic accelerators: a comparison between neuroscience and machine-learning approaches. PROCEEDINGS OF THE 48TH ANNUAL IEEE/ACM INTERNATIONAL SYMPOSIUM ON MICROARCHITECTURE (MICRO-48) 2015: 494-507
[19] Zidong Du, Krishna V. Palem, Lingamneni Avinash, Olivier Temam, Yunji Chen, Chengyong Wu: Leveraging the error resilience of machine-learning applications for designing highly energy efficient accelerators. ASP-DAC 2014: 201-206
[20] Tianshi Chen, Zidong Du, Ninghui Sun, Jia Wang, Chengyong Wu, Yunji Chen, Olivier Temam: DianNao: a small-footprint high-throughput accelerator for ubiquitous machine-learning. ASPLOS 2014: 269-284
[21] Jing Huang, Yuanjie Huang, Olivier Temam, Paolo Ienne, Yunji Chen, Chengyong Wu: A low-cost memory interface for high-throughput accelerators.CASES 2014: 11:1-11:10
[22] Chao Wang, Xi Li, Xuehai Zhou, Yunji Chen, Ray C. C. Cheung: Big data genome sequencing on Zynq based clusters (abstract only).FPGA 2014: 247
[23] Chao Wang, Xi Li, Xuehai Zhou, Yunji Chen, Koen Bertels: Co-processing with dynamic reconfiguration on heterogeneous MPSoC: practices and design tradeoffs (abstract only). FPGA 2014: 248
[24] Tianshi Chen, Qi Guo, Ke Tang, Olivier Temam, Zhiwei Xu, Zhi-Hua Zhou, Yunji Chen: ArchRanker: A ranking approach to design space exploration. ISCA2014: 85-96
[25] Yunji Chen, Tao Luo, Shaoli Liu, Shijin Zhang, Liqiang He, Jia Wang, Ling Li, Tianshi Chen, Zhiwei Xu, Ninghui Sun, Olivier Temam: DaDianNao: A Machine-Learning Supercomputer. MICRO 2014: 609-622
出版著作:
(1) 智能计算系统(第2版), 机械工业出版社, 2024-07, 第 1 作者
(2) 智能计算系统, AI Computing Systems, Morgan Kaufmann, 2022-10, 第 1 作者
(3) 智能计算系统实验教程, Experimental Course of AI Computing Systems, 机械工业出版社, 2021-08, 第 3 作者
(4) 智能计算系统, AI Computing Systems, 机械工业出版社, 2020-02, 第 1 作者
(5) 计算机体系结构, 清华大学出版社, 2011-06, 第 2 作者
发表期刊论文:
[1]赵永威, 郝一帆, 刘洋, 陈亦, 陈云霁. 硬连线LPU:大语言模型时代的处理器芯片新范式[J]. 计算, 2026, 2 (10): 18-24.
[2]陈云霁. 深度学习处理器:人工智能芯片基础研究之路[J]. 中国科学院院刊, 2026, 41 (6): 1276-1288.
[3]张振兴, 赵永威, 文渊博, 郭崎, 陈云霁. 深度学习处理器矩阵跨步访存冲突判定方法[J]. 计算机研究与发展, 2026, 63 (7): 1803-1815.
[4]陈云霁, 郭崎. AI for Technology:技术智能在高技术领域的应用实践与未来展望[J]. 中国科学院院刊, 2024, 39 (1): 34-40.
[5]陈云霁, 蔡一茂, 汪玉, 唐华, 何杰, 刘克, 郝跃. 集成电路未来发展与关键问题——第347期“双清论坛(青年)”学术综述[J]. 中国科学:信息科学, 2024, 54 (1): 1-15.
[6]樊哲, 南子渊, 郝一帆, 杜子东, 陈云霁. 基于自适应静态数据布局策略的深度学习张量程序自动生成框架[J]. 高技术通讯, 2023, 33 (11): 1160-1171.
[7]陈云霁. 于危机中育先机 于变局中开新局——努力抢占处理器芯片领域科技制高点[J]. 科学新闻, 2023, 25 (4): 52-53.
[8]陈云霁, 杜子东, 郭崎, 李威, 谭懿峻. Chip Learning:从芯片设计到芯片学习[J]. 中国科学院院刊, 2022, 37 (1): 15-23.
[9]陈云霁, 刘自鸿, 孙振莲. 实现科技强国梦,青年科技工作者的使命但当[J]. 科技导报, 2021, 39 (16): 86-88.
[10]陈云霁, 李威. 关于科研工作坚持问题导向的思考[J]. 中国科学院院刊, 2021, 36 (6): 698-702.
[11]杜伟健, 陈云霁, 支天, 吴林阳, 陈小兵, 庄毅敏. QingLong:一种基于常变量异步拷贝的神经网络编程模型[J].QingLong:A Neural Network Programming Model Based on Asynchronous Copy of Constant and Variable. 计算机学报, 2020, 43 (4): 587-599.
[12]李韦, 文渊博, 孙广中, 陈云霁. 提升高性能计算程序性能可移植性的领域特定语言[J].Domain-specific language for improving the performance portability of high-performance computing programs 高技术通讯, 2020, 30 (2): 141-149.
[13]陈云霁. 树立良好作风学风,是科研工作者的责任[J]. Building a good tradition for research.中国科学基金, 2019, 33 (6): 551-552.
[14]陈云霁, 窦勇, 梁云, 汪东升. 编者按[J]. 中国科学:信息科学, 2019, 49 (3): 245-246.
[15]周聖元, 杜子东, 陈云霁. 稀疏神经网络加速器设计[J]. 高技术通讯, 2019, 29 (3): 222-231.
[16]周聖元, 杜子东, 刘道福, 支天, 陈云霁. 低面积低功耗的机器学习运算单元设计[J]. An area and power-efficient machine learning functional unit.高技术通讯, 2019, 29 (1): 12-18.
[17]韩栋, 周聖元, 支天, 陈云霁, 陈天石. 智能芯片的评述和展望[J]. 计算机研究与发展, 2019, 56 (1): 7-22.
[18]王秉睿, 兰慧盈, 陈云霁. 深度学习编程框架[J]. 大数据, 2018, 4 (4): 56-63.
[19]陈云霁. 从人工智能到神经网络处理器[J]. 领导科学论坛, 2017, (2): 38-55.
[20]黄铁军, 施路平, 唐华锦, 潘纲, 陈云霁, 于俊清. 多媒体技术研究:2015——类脑计算的研究进展与发展趋势[J]. 中国图象图形学报, 2016, 21 (11): 1411-1424.
[21]陶建华, 陈云霁. 类脑计算芯片与类脑智能机器人发展现状与思考[J]. 中国科学院院刊, 2016, 31 (7): 803-811.
[22]陈云霁, 陈天石. 人工神经网络处理器[J]. 中国科学:生命科学, 2016, 46 (2): 223-224.
[23]黄元杰, 陈云霁, 吴承勇. 数据触发的基本块间弹性控制电路综合方法[J]. 高技术通讯, 2015, 25 (1): 46-53.
[24]刘雨辰, 王佳, 陈云霁, 焦帅. 计算机系统模拟器研究综述[J]. 计算机研究与发展, 2015, 52 (1): 3-15.
[25]房双德, 杜子东, 方运潭, 黄元杰, 李华伟, 陈云霁, 吴承勇. 面向低能耗的非精确异构多核上的运行时技术[J]. 高技术通讯, 2014, 24 (8): 791-799.
[26]李磊, 陈云霁, 章隆兵, 肖俊华. 基于可行序的数据竞争检测[J]. 高技术通讯, 2014, 24 (7): 669-676.
[27]陆超, 陈云霁, 刘少礼. 二维Mesh结构的片上网络中利用全局信息的路由算法[J]. 计算机辅助设计与图形学学报, 2014, 26 (6): 1007-1014.
[28]伍岳, 陈云霁, 陈天石, 郭崎, 张磊. An Elastic Architecture Adaptable to Various Application Scenarios[J]. Journal of Computer Science & Technology, 2014, 29 (2): 227-238.
[29]陈鹏, 张磊, 韩银和, 陈云霁. A General-Purpose Many-Accelerator Architecture Based on Dataflow Graph Clustering of Applications[J]. Journal of Computer Science & Technology, 2014, 29 (2): 239-246.
[30]尹一笑, 陈云霁, 郭崎, 陈天石. Prevention from Soft Errors via Architecture Elasticity[J]. Journal of Computer Science & Technology, 2014, 29 (2): 247-254.
[31]刘宏伟, 邱吉, 高翔, 陈云霁. 基于二进制插桩的共享指令集异构多核处理器进程迁移方法[J]. 高技术通讯, 2014, 24 (1): 23-28.
[32]王磊, 刘道福, 陈云霁, 陈天石, 李玲. 片上多核处理器共享资源分配与调度策略研究综述[J]. 计算机研究与发展, 2013, 50 (10): 2212-2227.
[33]张磊, 王颖, 陈云霁, 徐志伟, 张立新. 可重塑处理器:用户可定义的加速器中处理器架构[J]. 网络新媒体技术, 2012, 1 (6): 58-62.
[34]郭崎, 陈天石, 陈云霁. 基于模型树的多核设计空间探索技术[J]. 计算机辅助设计与图形学学报, 2012, 24 (6): 710-720.
[35]朱海涛, 李玲, 陈云霁, 钱诚. 一种用于通用处理器结构优化的矩阵乘法性能模型[J]. 小型微型计算机系统, 2012, 33 (5): 981-986.
[36]钱诚, 沈海华, 陈天石, 陈云霁. 超大规模集成电路可调试性设计综述[J]. 计算机研究与发展, 2012, 49 (1): 21-34.
[37]杨旭, 刘江, 钱诚, 苏孟豪, 吴瑞阳, 陈云霁, 胡伟武. 一种面向多核处理器的通用可调试性架构[J]. 计算机辅助设计与图形学学报, 2011, 23 (10): 1656-1664.
[38]李玲, 陈云霁, 刘道福, 钱诚, 胡伟武. An FFT Performance Model for Optimizing General-Purpose Processor Architecture[J]. Journal of Computer Science & Technology, 2011, 26 (5): 875-889.
[39]朱海涛, 陈云霁, 钱诚, 王玲, 胡伟武. 基于向量扩展多核处理器的矩阵乘法算法优化研究[J]. 中国科学技术大学学报, 2011, 41 (2): 173-182.
[40]王朋宇, 陈云霁, 沈海华, 陈天石, 张珩. 片上多核处理器存储一致性验证[J]. 软件学报, 2010, 21 (4): 863-874.
[41]高翔, 陈云霁, 王焕东, 唐丹, 胡伟武. System Architecture of Godson-3 Multi-Core Processors[J]. Journal of Computer Science & Technology, 2010, 25 (2): 181-191.
[42]王朋宇, 郭崎, 沈海华, 陈云霁, 张珩. 使用支持向量机的微处理器验证向量优化方法[J]. 高技术通讯, 2010, 20 (1): 68-74.
[43]马麟, 杨旭, 钟石强, 陈云霁. Testing content addressable memories with physical fault models[J]. 半导体学报, 2009, 30 (8): 109-115.
[44]沈海华, 卫文丽, 陈云霁. 覆盖率驱动的随机测试生成技术综述[J]. 计算机辅助设计与图形学学报, 2009, 21 (4): 419-431+441.
[45]王焕东, 高翔, 陈云霁, 胡伟武. 龙芯3号互联系统的设计与实现[J]. 计算机研究与发展, 2008, (12): 2001-2010.
[46]陈云霁, 张健, 沈海华, 胡伟武. 一种基于SAT的运算电路查错方法[J]. 计算机学报, 2007, (12): 2082-2089.
[47]陈云霁, 马麟, 沈海华, 胡伟武. 龙芯2号微处理器浮点除法功能部件的形式验证[J]. 计算机研究与发展, 2006, (10): 1835-1841.
荣誉奖励:
1、国家杰出青年科学基金获得者。
2、中国青年科技奖。
3、全国创新争先奖。
4、国家自然科学基金委“优秀青年基金。
5、教育部“青年长江学者”。
6、被MIT技术评论评为全球35位杰出青年创新者(2015年度)。
7、两次获得中国科学院优秀导师奖。
8、第一完成人获国家自然科学二等奖。
8、第一完成人获中国科学院杰出成就奖。
10、全国五一劳动奖章。
11、中国青年五四奖章。
12、何梁何利科技创新奖。
媒体报道:
1 陈云霁、陈天石:一腔孤勇,开启中国芯片“寒武纪” 刘潇 高中生之友 2026-04-01
2 为中国造“芯”,他们把不可能变为现实 新作文 2024-10-2
3 “龙芯”之路:廿载砺刃,一朝亮剑 包小西 七彩语文 2024-04-20
4 奋斗者 正青春 王丽华 快乐作文 2022-11-22
5 陈云霁:勇闯“芯片无人区” 王强 发明与创新(初中生) 2022-06-13
6 深度学习勇攻坚 云霁初开创新篇——记中国科学院计算技术研究所研究员陈云霁 蔡巧玉 科学中国人 2022-04-25
7 为AI装上中国芯 棉花糖 学苑创造(3-6年级阅读) 2020-05-10
8 陈云霁 智能爆发时代为AI装上中国芯 科学大观园 2019-09-01
9 陈云霁:智能爆发时代为AI装上中国芯 本刊编辑部 今日科技 2019-08-25
10 中国梦科技梦 致敬最美科技工作者 双子星寒武纪 深度学习处理器先驱 王渝生 中国科技教育 2019-08-15
11 中宣部等发布2019年“最美科技工作者”先进事迹 科技导报 2019-08-13
12 陈云霁:创“芯”国之重器 檀彦卓;支天 旗帜 2019-03-10
13 造“芯”双子星 李艳 创新世界周刊 2018-08-01
14 兄弟合璧“寒武纪” 孟醒 中国工业和信息化 2018-06-15
15 为AI装上中国芯的“双子星”刘垠 科学之友(上半月) 2018-05-01
17 人脑比人工智能聪明1亿倍 张晶 新长征(党建版) 2018-01-05
18 陈云霁:寻找人工智能新爆点 科学家 2017-07-08
19 中科院寒武纪NPU拟流片商用 今日电子 2017-06-15
20 兄弟俩让人工智能更智能 谷业凯 南方企业家 2017-01-01
陈云霁:智能爆发时代为AI装上中国芯
本刊编辑部
苦心耕读十余年,陈云霁是少年班走出来的研究员, 勇于挑战创新,他想让计算机更聪明。带领团队研制国际上首个深度学习处理器芯片“寒武纪”,被《Science》杂志评价为“深度学习处理器的先驱和领导者”。
国际首个深度学习处理器——寒武纪芯片研发者之一的陈云霁,无论是在学习和工作道路上,一直是“脚踩油门”:14岁进入中国科学技术大学少年班学习,24岁获得博士学位,25岁成为8核龙芯3号主架构师,29岁晋升为研究员,33岁荣获中国青年科技奖和中科院青年科学家奖……
毕业后,陈云霁如愿加入中科院计算所,跟随计算所研究员胡伟武硕博连读,成为“龙芯1号”设计研发团队中最年轻的成员,这一干就是12年。“没有‘龙芯’,就没有今天的陈云霁,是胡老师的言传身教,带我走上芯片行业。”在计算所,陈云霁获得了博士学位,并在“龙芯1号”后成为8核处理器“龙芯3号”的主架构师。
行走于科研之路,多数时候是寂寥的。可陈云霁并不孤独,因为有弟弟一路相伴。在陈云霁25岁这年,他与主攻算法的弟弟陈天石开始智能算法和芯片设计的交叉研究。他们给这款处理器取了个很有深意的名字——“寒武纪”,用地质学上生命大爆发的时代寓意人工智能的未来。
2008年,人工智能仍处于低谷时期,大家都觉得人工智能芯片是一件离自身很遥远的事情,但在陈云霁看来,它却是计算机领域里最具有吸引力的课题之一。招不来学生、申请不到项目是摆在兄弟俩面前的难题,在办公室没日没夜地熬,一张折叠床成了他的“标配”,陈云霁只身一人完成了第一个处理器架构原型的逻辑设计。时值2008年北京奥运会举办期间,单位放假,陈云霁在一个没有空调的宿舍里写论文。虽挥汗如雨,但心情愉悦。论文最终被体系结构领域三大旗舰会议国际高性能计算机体系结构会议 (HPCA) 录用,这也是HPCA历史上第一篇第一作者来自中国大陆的论文。
陈云霁的付出终究获得了回报。从2013年至2015年,陈云霁与合作者的数篇学术成果相继在国际顶级会议中发布,在业内初露锋芒。2014年,陈云霁团队获得ASPLOS的最佳论文奖,这是亚洲地区第一次在计算机体系结构的顶级会议上获奖。“跟现在的热闹相比,当时更多的是一种孤独的感觉。”陈云霁坦言。
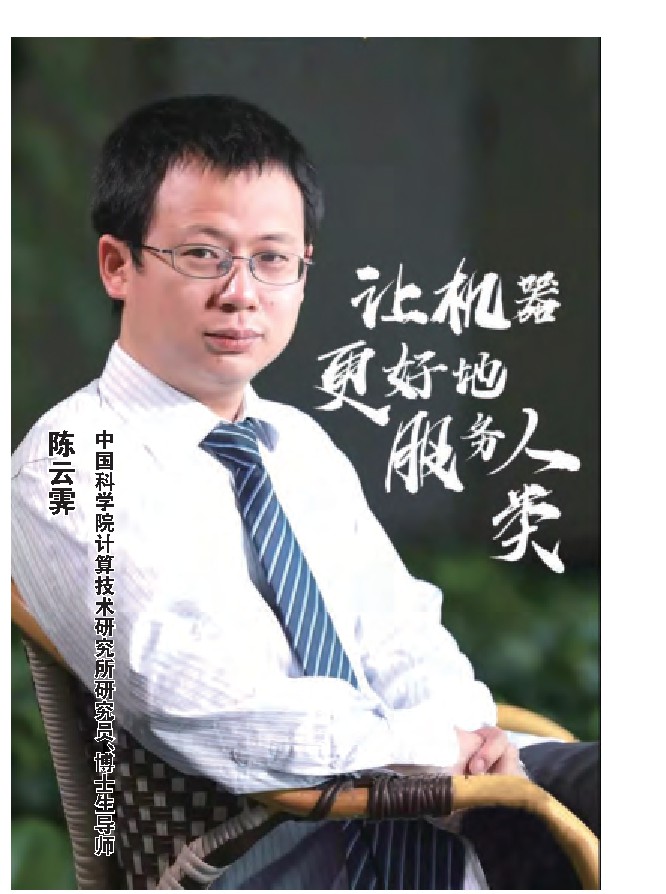
2016年,陈云霁以及其所在团队为神经网络加速器设计了一套名为Cambricon的指令集,在2016年的ISCA会议中获得了同行评议的最高分。同年3月,经过正式注册登记,其所在团队孵化出了中国的AI独角兽——芯片方案供应商寒武纪。该公司聚焦于为人工智能算法提供硬件支持,以及设计能耗表现优异的专用硬件加速器,是全球第一个拥有成熟产品的智能芯片公司。2016年,全球首款可商用的深度学习处理器寒武纪1A问世,它模拟了人脑的运算方式,使其可以更迅速、更精准地进行分析。陈云霁曾公开展示了在嵌入深度神经网络处理器“寒武纪”后计算机进行图片识别的速度——没有嵌入“寒武纪”的计算机,每秒只能识别一两张图片;嵌入“寒武纪”后,手机、电脑等智能终端对图片、音频等的理解速度能提升近百倍。
在陈云霁看来,寒武纪的长期奋斗目标是,让人工智能芯片计算效率提高1万倍,功耗降低1万倍。寒武纪就是想设计出一款人工智能的专用芯片。它可以在计算机中模拟神经元和突触的计算,对信息进行智能处理,还通过设计专门存储结构和指令集,每秒可以处理160亿个神经元和超过2万亿个突触,功耗却只有原来的1/10,这样未来就有希望把整个“阿尔法狗”的系统都装进手机。
正如工业时代的蒸汽机、信息时代的通用CPU,智能时代也将会出现智能芯片这一核心物质载体。芯片研究的使命将从信息时代的计算转变为支撑机器智能。面向未来,正如地质年代寒武纪产生了进化史上的一个重要事件“寒武纪生命大爆发”,“寒武纪”系列智能芯片也将伴随人类智能科技的发展而不断壮大。
今日科技 . 2019 (08) : 15
陈云霁:创“芯”国之重器
檀彦卓支天
中国科学院计算技术研究所
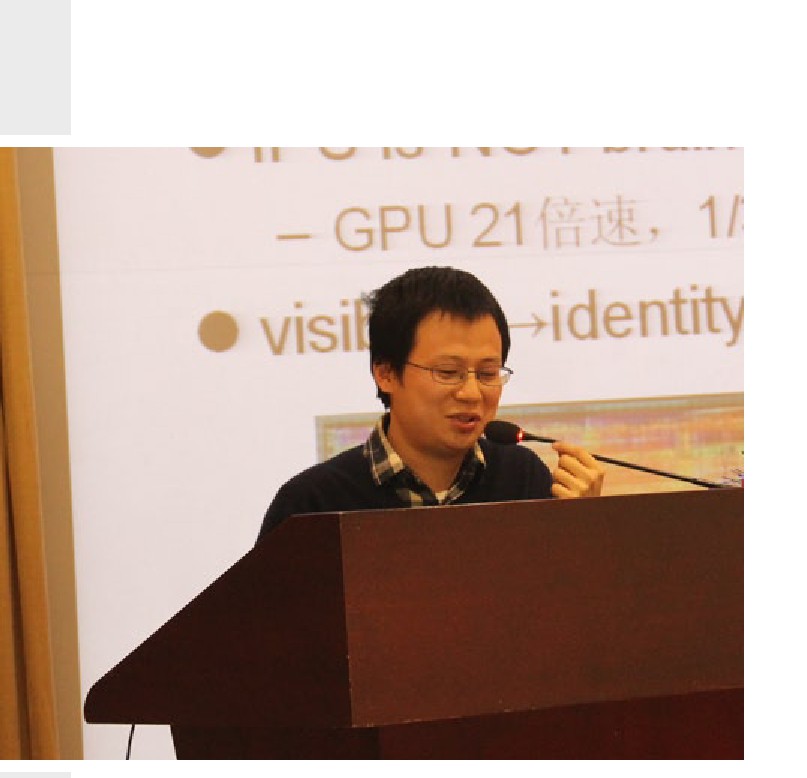
>陈云霁在学术会议上作报告
人物名片
陈云霁, 中国科学院计算技术研究所研究员, 博士生导师。现任中国科学院脑科学卓越中心特聘研究员、计算所智能处理器中心主任、寒武纪党总支书记。他带领智能处理器研究中心 (寒武纪课题组) , 研制国际上首个深度学习专用处理器芯片“寒武纪”, 曾荣获全国创新争先奖、中国青年科技奖、国家万人计划“青年拔尖人才”称号等。
大约5.2亿年前,在地质学上被称作“寒武纪”的时代,大量无脊椎动物在短时间内出现“生命大爆发”。
如今,“寒武纪”这个名字被人们再次提起时,多是指中科院计算所研发的人工智能芯片处理器,意喻着人工智能即将迎来大爆发的时代。
“寒武纪”是由陈云霁和他同在中科院计算技术研究所的弟弟陈天石带领团队研发的一款达到国际一流水平的系列智能芯片。陈云霁14岁考入中国科学技术大学少年班,24岁在中科院计算所取得计算机博士学位,29岁就晋升为研究员,被认为是“弯道超车”的天才。如今,陈云霁担任中科院计算所智能处理器中心主任,带领团队进行智能芯片的研究开发,成为中国在人工智能时代实现“弯道超车”的领跑者。
第一次“弯道超车”——少年班走出来的研究员
寸头、圆脸、黑框眼镜,深灰羊毛衫、双肩包,初次见面谁也不会把看上去学生模样的陈云霁与中国青年科技奖、国家万人计划“青年拔尖人才”等头衔联想在一起。
陈云霁1983年出生于江西南昌的一个普通知识分子家庭。受父母影响,他打小就热爱学习、博览群书,向往着成为一名科研工作者。
谈起童年,他认为兴趣对自己的影响很大,“父母很注意培养我的好奇心。父母书架上的书,不管是工程类的,还是历史方面的,我都爱看。”陈云霁至今还对历史很痴迷,他认为这和启蒙教育关系很大。
陈云霁小学三年级就学完小学数学课程,小学毕业时又学完初中数学课程,同时考上南昌十中。中学期间,他在班里整体成绩并不突出。他心里很清楚,实现“科学家”梦想,考上好大学是先决条件。
经过一段时间努力,他考入中国科学技术大学少年班,14岁的陈云霁完成人生第一次“弯道超车”。
然而,进了少年班以后,他发现自己并不是“最快”的那一个。陈云霁自认为在科大少年班既不是最聪明的,也不是最勤奋的,成绩在班上的“后半截”。“学习、生活各方面都有点准备不足。”他笑着说,“‘弯道超车’得下苦功夫的道理,这是在科大少年班学到的。”
中科大少年班可以根据兴趣来选专业,班里不少人都选了数学或者物理,陈云霁却犯了难。“那时候大家都觉得自己是数学天才。”陈云霁回忆,“记得数学大师陈省身给少年班有个题词,是‘不争第一’。我想,拿不到第一不要紧,但是得从事个感兴趣的方向。”
大学三年级,对未来还有些懵懂的陈云霁就把计算机系所有实验室的门敲了个遍,问是否接收本科生。最后,教计算机体系结构的周学海教授所在的实验室收下了他。通俗地说,计算机体系结构就是研究如何用晶体管的“砖石”搭出计算机的“大楼”。在研发过程中,尽管做的都是些打下手的“杂活”,却让陈云霁第一次恣意徜徉在这座“大楼”中。
2002年,陈云霁加入计算所,跟随胡伟武研究员硕博连读,成为当时龙芯研发团队中最年轻的成员。没想到,这一干,就是12年。陈云霁说:“没有‘龙芯’,就没有今天的陈云霁,是胡老师的言传身教,带我走上芯片行业。”
博士毕业后,陈云霁留在了计算所。年仅25岁的陈云霁,成为8核龙芯3号的主架构师。
第二次“弯道超车”——深度学习处理器领域的引领者
2008年,当时人工智能这个“风口”还没有起来,陈云霁就已经开始研究如何用计算机模拟人的智能。用更专业的话来说,就是通过体系结构来设计神经网络芯片。而在此之前,计算机硬件的运行速度和功能已经成为神经网络应用的瓶颈。
北京奥运会期间,已经放假的陈云霁躲在宿舍里挥汗如雨。很快,他撰写的论文被计算机系统结构领域顶尖国际会议国际高性能计算机体系结构会议(HPCA)录用,这也是HPCA历史上第一篇来自中国大陆的论文。
研究人工智能的道路并不平坦,在实践中陈云霁遇到了很多困难。招不来学生、申请不到项目……陈云霁只身一人在办公室没日没夜地熬,完成了第一个处理器架构原型的逻辑设计,一张折叠床成了他办公室的“码农标配”。
更为糟糕的是,在他提出了一系列基于人工智能方法的处理器研发技术,并多次向体系结构顶级会议投稿后,却总是以被拒而告终。
陈云霁并没有被困难吓倒,他相信,只要坚持“人工智能”梦,把研究做得更深入,外在的困难总是能克服的。
经过多年的积累,陈云霁终于在2014年迎来硕果。他带领的团队和其他团队合作的成果:“一种小尺度的高吞吐率机器学习加速器”,智能处理的能效达传统芯片的近百倍,其论文在国际体系结构支持、编程语言和操作系统国际会议(ASPLOS)上获得“最佳论文奖”。这是大陆科研机构首次在国际计算机系统结构领域顶级会议上获得最佳论文奖,也是亚洲首次、美国之外国家第二次获得ASPLOS会议的最佳论文。
凭借扎实的科研成果,陈云霁完成了人生的第二次“弯道超车”。
如今,陈云霁开创的深度学习处理器这一方向,已成为国际计算机体系结构领域最热门的学术研究方向之一。他的相关论文受到哈佛、谷歌等上百所国际知名研究机构和图灵奖得主、中美两国院士等一大批国际知名学者引用跟踪。
国际权威学术杂志Science称陈云霁为深度学习处理器的“先驱”和“国际上该方向公认的引领者”。2015年,陈云霁被MIT Technology Review评为全球35位35岁以下青年创新者。
第三次“弯道超车”——努力建立信息产业新生态
党的十九大报告提出,“推动互联网、大数据、人工智能和实体经济深度融合”。国务院也印发了《新一代人工智能发展规划》,指导我国人工智能的发展。党和国家对这一重要战略机遇的重视可见一斑。
人工智能时代正在迫近,如何实现中国在人工智能的“弯道超车”?能否建立起以中国为主导的、开放共赢的信息产业新生态?以陈云霁等为代表的中国科学家们正在努力探索。
“人工智能不是空中楼阁,必须附着在某个东西上。”陈云霁介绍说,正如工业时代的蒸汽机、信息时代的通用CPU,智能芯片作为智能产业的核心物质载体,决定了智能产业未来的应用与发展,对我国引领智能时代的产业发展,有着不可或缺的重要性。
2017年,陈云霁率领其团队成功研制了国际首个深度学习处理器芯片——“寒武纪”。
陈云霁曾这样来解释自己的灵感来源:“人的大脑是已知最智能的物体。如果能把大脑中神经元和突触数字化抽象出来,这样的数字化网络某种程度上可能就继承了人脑对信息的处理能力。”
一方面,神经网络是智能处理的好方法;另一方面,通用处理器在这方面效率很低。“如果要用通用处理器搭建一个人脑规模突触的神经网络,可能需要建一个电站来给它供电了。”陈云霁想到,为什么不能用人工智能的办法来设计一款专门的芯片呢?
“寒武纪”恰恰解决了这一问题:它可以在计算机中模拟神经元和突触的计算,对信息进行智能处理,还通过设计专门存储结构和指令集,每秒可以处理160亿个神经元和超过2万亿个突触,功耗却只有原来的1/10,未来甚至有希望把整个“阿尔法狗”系统装进手机。如今,“寒武纪”已成功应用于数千万台手机中,为手机提供更高的实时智能处理能力。
伴随人类智能科技的不断发展,芯片研究的使命将从信息时代的计算转变为支撑机器智能,建立信息产业新生态刻不容缓。“要以党和国家的需求为己任,抓住智能时代前所未有的机遇,努力将‘寒武纪’系列智能芯片成果不断发展壮大。”对于中国在人工智能时代实现“弯道超车”,陈云霁信心十足。
来源:旗帜 . 2019 (03) : 80-81
中国科技创新人物云平台暨“互联网+”科技创新人物开放共享平台(简称:中国科技创新人物云平台)免责声明:
1、中国科技创新人物云平台是:“互联网+科技创新人物”的大型云平台,平台主要发挥互联网在生产要素配置中的优化和集成作用,将互联网与科技创新人物的创新成果深度融合于经济社会各领域之中,提升实体经济的创新力和生产力,形成更广泛的以互联网为基础设施和实现工具的经济发展新形态,实现融合创新,为大众创业,万众创新提供智力支持,为产业智能化提供支撑,加快形成经济发展新动能,促进国民经济提质增效升级。
2、中国科技创新人物云平台暨“互联网+”科技创新人物开放共享平台内容来源于互联网,信息都是采用计算机手段与相关数据库信息自动匹配提取数据生成,并不意味着赞同其观点或证实其内容的真实性,如果发现信息存在错误或者偏差,欢迎随时与我们联系,以便进行更新完善。
3、如果您认为本词条还有待完善,请编辑词条。
4、如果发现中国科技创新人物云平台提供的内容有误或转载稿涉及版权等问题,请及时向本站反馈,网站编辑部邮箱:kjcxac@126.com。
5、中国科技创新人物云平台建设中尽最大努力保证数据的真实可靠,但由于一些信息难于确认不可避免产生错误。因此,平台信息仅供参考,对于使用平台信息而引起的任何争议,平台概不承担任何责任。


 点击图片查看原图